Workers AIで他人のデータ混入、原因と対応【2026年10月】
IT Picks編集部
IT Picks
2026年10月19日(米国時間)、Cloudflare は文章や画像から金額・日付などの値を「型付き」で取り出す新しい AI モデル「Clairic(クレアリック)」を、AI 推論サービス「Workers AI」でプレビュー公開しました。
LLM に「請求書の金額と期日を JSON で返して」と頼む使い方は広まっていますが、形が崩れる・数字を読み違えるといった失敗がつきものでした。Clairic は文章を生成せずに指定した型どおりの値だけを返すモデルで、構造化データの取り出しを LLM から切り離す試み、という位置づけです。
この記事はこんな人向けです
一言でいうと、「取り出したい項目と型」を渡すと、項目ごとに値と確信度を返してくれる抽出専用のモデルです。
| 項目 | 内容(公式発表より) |
|---|---|
| モデル ID | @cf/cloudflare/clairic |
| 入力 | 文章(state)と、任意で画像4枚まで |
| 出力 | 項目ごとに指定した型の値、または null(JSON) |
| できること | 値の抽出・計算・推定・予測 |
| 料金 | 100万入力トークンあたり$0.10(出力の料金なし) |
| 状態 | プレビュー。オープンウェイトでの公開も予定 |
Cloudflare はこれを「System One」型のモデルと呼んでいます。じっくり推論する LLM(System Two)に対し、速く正確に答えることに絞ったモデル、という意味です。同社はすでに、決まった選択肢から選ぶ「判断モデル」の Clef を出しており、Clairic は値そのものを返す「抽出モデル」の最初の1つになります。
公式ブログは、LLM での抽出の弱点として次の3つを挙げています。
Clairic はトークン(文字)を生成しません。入力を1回読んで、各項目を型のルールに沿って決めます。そのため、答えは必ず指定した型の値か null になります。
返ってくる情報は次のとおりです。
null項目の数に上限はなく、30項目を聞いても3項目とほぼ同じ費用だ、と説明されています。
項目ごとに型を指定します。Changelog に載っている型は、日付・時刻の3つを含めて9つです。
| 型 | 返ってくるもの |
|---|---|
| text | 入力の文字列そのものと、その文字位置 |
| number | 読み取った、または計算した数値(整数・小数の桁数を指定できる) |
| date / time / datetime | ISO 形式の日付・時刻 |
| duration | 指定した単位の長さ(例:日数) |
| list | 当てはまる文字列・数値・日付を、出てきた順に |
| estimate | min〜max の範囲の推定値(中央値と80%区間) |
| forecast | 時系列の先の値(最大64ステップ) |
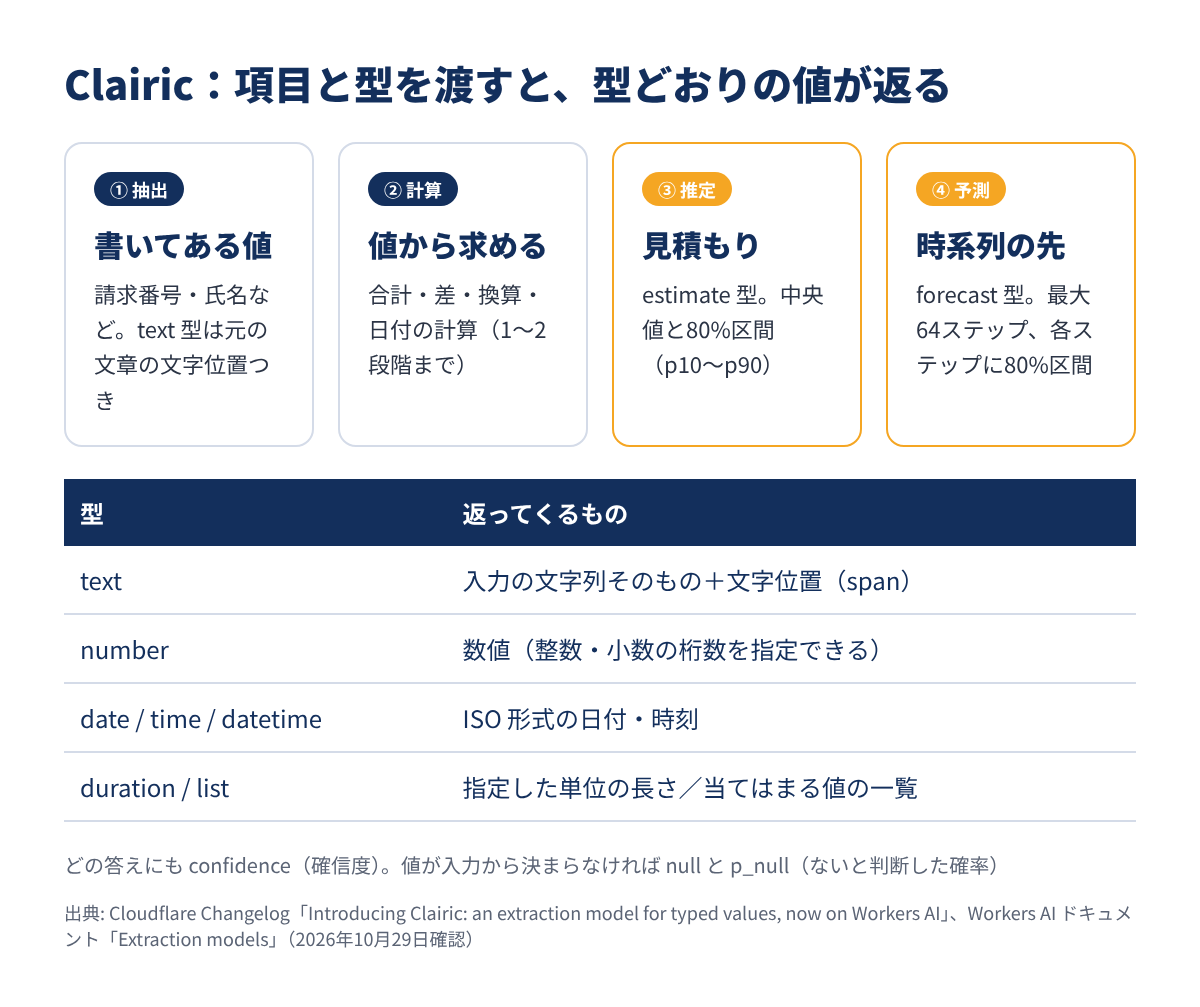
請求書に書かれた請求番号や金額のように、入力にそのまま書いてある値を返します。
公式ブログの例では、「本体 $649.00、税 $52.10」というメールから、合計の 701.1 を返しています。配達日とメールの日付から経過日数(11日)を出す例もあります。
似た物件の売買価格を並べて、対象の物件の価格を中央値と80%区間で返す例が紹介されています。
米国の空港の保安検査の人数(TSA)で翌日の人数を21日続けて予測し、平均の誤差は3.3%、21日中17日が80%区間に入ったとしています。
Worker からは env.AI.run()、外部からは REST API(/ai/run)で呼び出します。AI Gateway 経由でも使えます。モデルページの例を短くすると、次のような形です。
const response = await env.AI.run("@cf/cloudflare/clairic", {
  model: "clairic",
  state: "Invoice INV-2291 from Northwind Supply, issued 2026-09-02, net 30. ...",
  fields: {
    invoice_number: { type: "text" },
    due_date: { type: "date", instructions: "Issue date plus the net payment days" },
    total: { type: "number", decimals: 2, unit: "USD",
             instructions: "Amount due including shipping" },
    po_number: { type: "text", instructions: "Purchase order number" },
  },
});
応答例では、invoice_number が “INV-2291”(文字位置つき)、due_date が発行日に30日を足した “2026-10-02”、total が 1080 でした。請求書に書かれていない po_number は、value が null で返っています。
モデルページに書かれている主な仕様は次のとおりです。
| 項目 | 内容 |
|---|---|
| コンテキストウィンドウ | 65,536トークン |
| 項目(fields) | 1つ以上、上限なし。8,192トークンの1回分に収まらない分は並列に分けて処理 |
| 画像 | PNG・JPEG・WebP を最大4枚(1枚4MiB・合計8MiB)。URL では渡せない |
| 日付の基準 | reference_date で指定できる |
年のない日付は文脈から解釈されます。「今日から何日後」のように今日の日付に依存する項目では、reference_date を指定するか、入力に「Today: 2026-10-19」のような行を入れるよう案内されています。
なお、応答の usage には、入力の文章(state_tokens 61)とは別に、項目の定義(schema_tokens 472)も数えられていました。短い文章でも、項目の定義が長いとトークン数が増える点は押さえておきたいところです。
料金と提供状況は次のとおりです(2026年10月29日時点の公式ページ)。
| 項目 | 内容 |
|---|---|
| 料金 | 100万入力トークンあたり$0.10(9,091 Neurons) |
| 出力の料金 | なし(トークンを生成しないため) |
| 無料枠 | Workers AI 全体で1日10,000 Neurons(Workers Free / Paid 共通) |
| 超過分 | Workers Paid で1,000 Neurons あたり$0.011 |
| 有料プランが必須か | 有料の支払い方法が必要なモデルの一覧にClairic は入っていない |
| オープンウェイト | 公開予定。時期は未定 |
料金ページの数字から計算すると、無料枠の10,000 Neurons はClairic の入力でおよそ110万トークン分にあたります(ほかのモデルを使えばその分減ります)。
対応言語については、2026年10月29日時点の公式ページに記載がありません。公式の例はすべて英語です。
また、モデルページの利用条件には、提供の継続を保証しない(「AS IS」での提供)と書かれています。プレビューの段階なので、本番の仕組みに組み込むときはこの点も踏まえておくと安心です。
Workers AI では10月、別のモデル(GLM-5.3)で他の利用者のデータが応答に混ざる問題も公表されています。
Cloudflare 自身が、いまのモデルは初期の版だとして、次の点を挙げています。
解説ページ「Extraction models」でも、支払いの承認など取り消せない処理の前には、別の根拠と照合するか人が確認するよう案内されています。confidence や p_null を使って、自動で通すものと人が見るものを分けるのが前提の設計です。
公式ブログでは、破損した商品の問い合わせメールに対応する流れを、2通りで比べています(Cloudflare 自身の計測です)。
| 工程 | Clairic → Clef → GLM-5.3 | すべて GLM-5.3 |
|---|---|---|
| ① 値の抽出 | Clairic 0.46秒 | 16.1秒 |
| ② 対応の判断 | Clef 0.22秒 | 21.9秒 |
| ③ 返信文の作成 | GLM-5.3 18.6秒 | 16.4秒 |
| 全体 | 19.3秒 | 61.7秒 |
| 100万件あたりの費用 | $6,032 | $11,740 |
組み合わせた構成は約3.2倍速く、費用は49%安いという結果です。どちらも事実と判断は正しく出せたうえで、修理費の見積もりは Clairic では毎回同じ値、GLM-5.3 では実行のたびに変わった、とも書かれています。
値の取り出しは Clairic、判断は Clef、文章は LLM——と役割を分けるのが Cloudflare の提案です。LLM には元のメールを渡さずに済むため、プロンプトインジェクションの影響を受けにくくなる点も挙げられています。
Hacker News では、公式ブログの投稿に75ポイント・7件のコメント(2026年10月29日時点)が付きました(出典)。
ユーザーの giancarlostoro 氏は、オープンウェイト版を使いたいと書いています(出典)。dstu 氏も、Jev のような判断モデルと LLM の中間を埋める存在になりそうだとして、オープンウェイトの公開が早いことを期待しています(出典)。
使い道として、spdustin 氏は固有表現の抽出や、意図とスロットの抽出にも向いていそうだと述べています(出典)。
一方、cat-whisperer 氏はベンチマークがまだ公開されていない点を指摘しています(出典)。公式ブログに載っている数字は、上の比較のような自社の例での計測が中心です。
Clairic の一番の価値は、「必ず型どおりの値か null が返る」ことだと思います。LLM での抽出では、JSON の検証や再試行の仕組みを自前で組むのが当たり前でした。その部分をモデル側で引き受けてくれるのは、請求書・問い合わせ・ログの処理を作る開発者にとって分かりやすい利点です。
出力の料金がかからず、100万入力トークンあたり$0.10という価格も、項目の多い抽出を大量に回す用途に向いています。一方で、日本語の文書でどこまで使えるかは公式に書かれておらず、現時点では自分のデータで確かめる必要があります。
また、性能の数字はCloudflare 自身の例での計測です。プレビューで計算や予測の弱さも明示されているので、まずは確信度の低い答えを人が確認する形で、小さな業務から試すのが現実的だと考えています。オープンウェイト版が出れば自前の環境でも動かせるので、その公開を待ちたいところです。
Cloudflare は10月、Deno のチームの合流も発表しており、開発者向けプラットフォームの動きが続いています。
Cloudflare の抽出モデル「Clairic」のポイントをまとめます。
@cf/cloudflare/clairic)でプレビューLLM で構造化データを取り出す処理を作っている人は、まず公式のモデルページで呼び出し例と応答の形を確認し、自分の文書で取り出したい項目と型を書き出しておくのがおすすめです。