東大ら、大気モデルをClaude Codeで移植し1.71倍速【2026年11月】
IT Picks編集部
IT Picks
2026年11月13日、東京の AI 企業 higurashi が、日本語で話せる音声対話 AI「Haru-4B」をオープンモデルとして無償で公開しました。人と電話で話すときのように、相手の声を聞きながら同時に話せる「全二重(ぜんにじゅう)」のモデルで、相づちや割り込み、笑いまで返してきます。
モデルの重みは Hugging Face、動かすためのコードは GitHub にあり、ライセンスは商用利用も禁じていない Apache License 2.0 です。公式の電話番号にかければ、PC が無くても今すぐ声を聞けます。日本語の音声 AI を自分で作りたい開発者にとって、自由に使える土台が1つ増えたという位置づけです。
この記事はこんな人向けです
Haru-4B は、声を入れると声で返す(speech-to-speech)、40億パラメータ(4B)の音声対話モデルです。文字に起こしてから返事を考える従来の音声 AI と違い、1つのモデルの中で「聞く」と「話す」を同時に進めます。
| 項目 | 内容 |
|---|---|
| 開発元 | higurashi株式会社(2024年10月設立、東京都文京区) |
| 公開日 | 2026年11月13日 |
| 種類 | 全二重の音声対話モデル(事前学習済みのベースモデル) |
| 大きさ | 4B(言語モデル部分は Qwen3.5-4B がベース) |
| 対応言語 | 日本語・英語・中国語・韓国語・スペイン語・ポルトガル語・ドイツ語・フランス語・ロシア語の9言語 |
| 学習した音声 | 4,000万時間以上(160以上の言語) |
| 遅延 | MacBook(M1 Max)で約65ミリ秒 |
| ライセンス | Apache License 2.0(コードと重み) |
| 試し方 | 電話デモ・NVIDIA GPU の PC・Apple シリコンの Mac |
注意したいのは、「事前学習済みのベースモデル」として研究用に公開されている点です。ChatGPT のような完成したアシスタントではなく、会話の自然さを学んだ「土台」です。公式も、事実を調べる用途には向かず、アシスタントのように指示に従うものではないと明記しています。
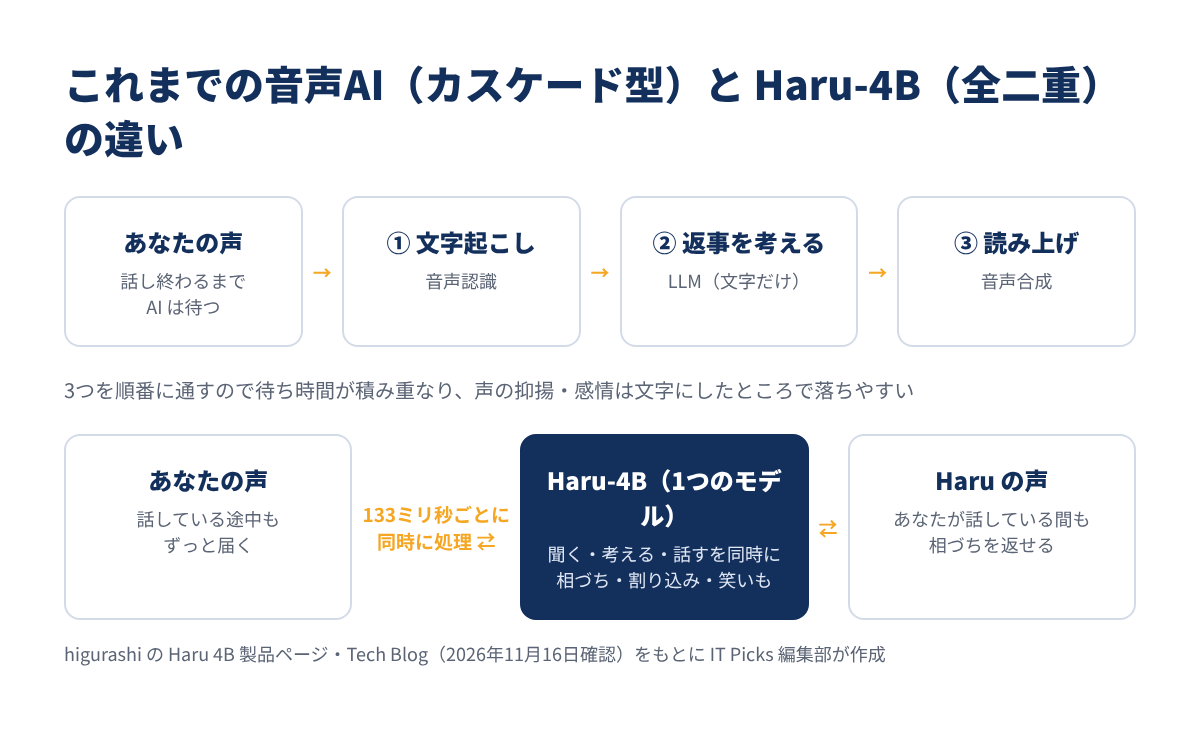
これまでの多くの音声 AI は、① 文字起こし → ② 返事を考える → ③ 読み上げの3段階を順番に通す「カスケード型」でした。この形だと、こちらが話し終わるまで AI は待つしかなく、待ち時間も3段階分たまります。声の抑揚や感情も、文字にした時点で落ちてしまいます。
Haru-4B は、あなたの声・Haru の声・Haru の文字の3つの流れを、133ミリ秒(1秒に7.5回)ごとに同時に処理します。だから、こちらが話している途中でも「うんうん」と相づちを打ったり、話がかぶっても会話を続けたりできます。
学習には、AI で作った会話ではなく実際の人の会話の録音を使っています。合成した会話データや合成音声は、あえて学習データから外しています。最長60分の長い会話も学んでいて、公式のデモでは、ユーザーの冗談に笑ったり、話題が真剣になると口調が落ち着いたりする様子が聞けます。
話す人物は、文字で書いた「キャラクターカード」で決めます。名前・性格・相手との関係・状況などを書く形式です。声は、3秒〜3分の参照音声を渡すとその声で話します。
ただし、声のサンプルは付いていません。自分で使う権利のある声を用意する必要があります。公式は、参照音声の声をまねられるので、権利のある声だけを使うよう注意しています。
音声を「1秒に7.5個」という少ない数のデータで表し、小さな部品(MLP)が1回の計算で次の音声を作ります。この工夫で計算の回数が減り、手元のマシンでも会話のテンポについていけるようになっています。
公式が出している遅延は、Apple の M1 Max を積んだ MacBook で、専用の Mac アプリを使ったときに約65ミリ秒(中央値65.2ミリ秒)です。有線のマイクとヘッドホンでの値で、マイクに声が入ってから AI の声が耳に届くまでの処理が入っています。
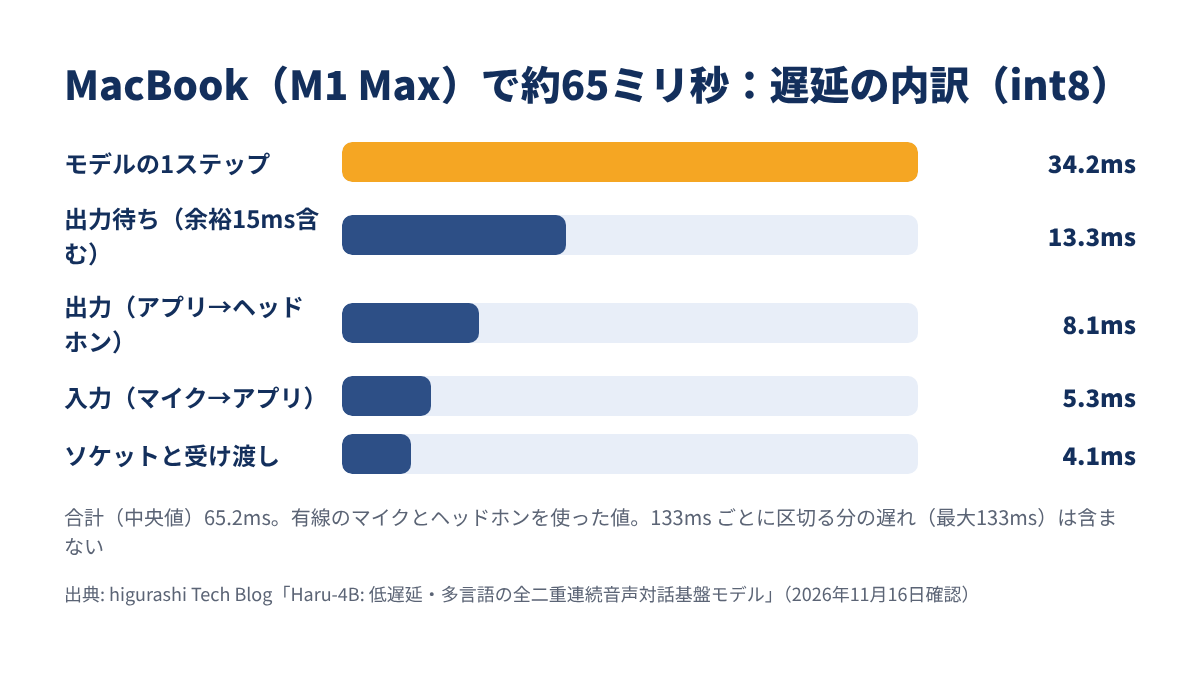
内訳で一番大きいのはモデルの計算(34.2ミリ秒)です。なお、この65ミリ秒には、音声を133ミリ秒ずつに区切る分の遅れ(最大133ミリ秒)は入っていません。GPU サーバーでは、NVIDIA B300 で1回の計算が約15ミリ秒とされています。
| 学習・開発の数字 | 内容 |
|---|---|
| 事前学習の音声 | 4,000万時間以上(160以上の言語、主要9言語) |
| 全二重の会話データ | 1,300万時間以上(1本の録音を話者ごとに分ける自社モデルで作成) |
| 一番長い会話 | 60分 |
| 学習に使った GPU | NVIDIA B200 を256基、約8日 |
| 支援 | 経済産業省・NEDO の GENIAC、AWS |
Bluetooth のイヤホンは遅延が100ミリ秒以上増えると公式が注意しています。自然なテンポを試すなら、有線のマイクとヘッドホンが向いています。
日本語で使える全二重のオープンモデルは、Haru-4B が初めてではありません。J-Moshi、LLM-jp の LLM-jp-Moshi が先に公開されていて、Haru は2番目のシリーズにあたります。違いを並べると次のとおりです。
| Haru-4B | J-Moshi | LLM-jp-Moshi-v1 | |
|---|---|---|---|
| Hugging Face での公開 | 2026年11月 | 2025年1月 | 2026年1月 |
| ベース | Qwen3.5-4B(多言語の LLM) | Moshi(7B、英語) | Moshi(7B、英語) |
| 大きさ | 4B | 7B | 7B |
| 学習した音声 | 4,000万時間以上 | 日本語の会話 約7万時間 | 日本語の会話 約7万時間 |
| 言語 | 9言語 | 日本語 | 日本語 |
| キャラ・声の指定 | ○(カード+参照音声) | — | — |
| ライセンス | Apache 2.0 | CC BY-NC 4.0(非営利のみ) | Apache 2.0 |
※ 約7万時間は Haru の公式ブログの説明。J-Moshi・LLM-jp-Moshi の公開日とライセンスは各モデルの Hugging Face のページ(2026年11月16日時点)
IT Picks として注目したいのは、モデルが小さいのに、学習した音声の量がけた違いに多い点です。J-Moshi は研究用の非営利ライセンスなので、商用のサービスに組み込みたい人にとっては、Apache 2.0 の Haru-4B と LLM-jp-Moshi が選択肢になります。キャラクターと声を後から決められるのも、Haru-4B ならではの違いです。
公式に書かれている、自分のマシンで動かすための条件を表にまとめました。
| 動かし方 | 必要なもの | 中身 |
|---|---|---|
| NVIDIA GPU の PC | GPU メモリ約12GB、Python 3.10以上 | PyTorch 版。ブラウザで話せる Web デモ |
| Apple シリコンの Mac | macOS 13以降、メモリ16GB が実用上の最低、Command Line Tools、Python 3.10以上 | MLX 版。Mac のネイティブアプリ |
| GPU サーバー | vLLM-Omni | 同時にたくさんの会話をさばく本番向け |
| 共通 | 空き容量(モデルは約10.5GB)、有線のマイクとヘッドホン | Hugging Face から初回に自動で取得 |
モデルのファイル(model.safetensors)には、言語モデル・音声の部品・音声コーデックの重みがすべて入っていて、Hugging Face のページでは「5B params」と表示されています。名前の「4B」は言語モデルの大きさです。
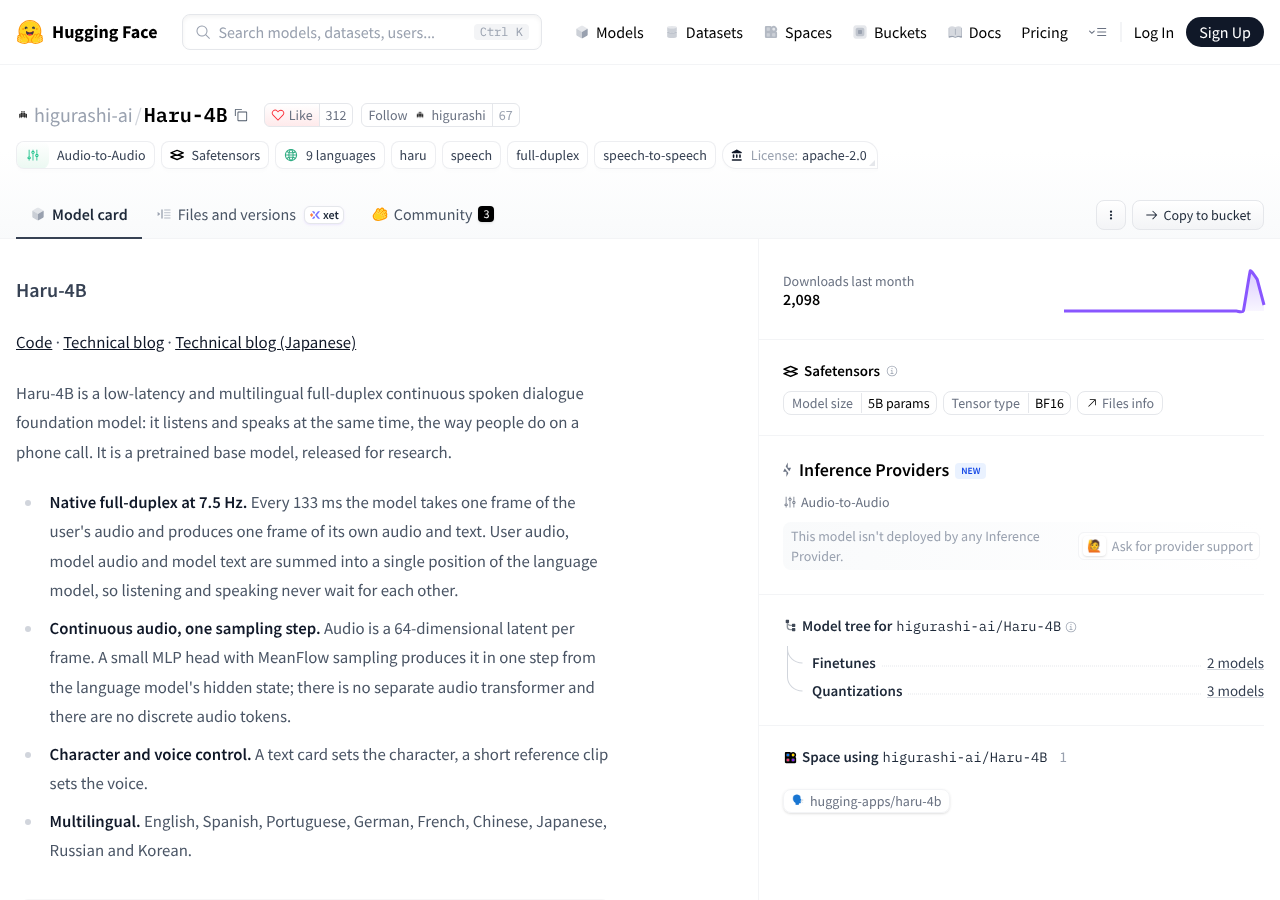
GPU が12GB 未満の PC や、Intel の Mac 向けの手順は公式にありません。手元のマシンが表の条件に届かない場合は、まず電話デモで試すのが現実的です。
試し方は大きく3つです。目的と手元のマシンで選びましょう。
公式の製品ページに、Haru-4B と話せる電話番号が載っています。「自己紹介をお願いします」から話し始めるのが公式のおすすめです。
| 電話番号 | 声 |
|---|---|
| 050-5444-3154 | 日本語・男性 |
| 050-5444-3155 | 日本語・女性 |
公式は「GPT2 程度の知性を期待して」と書いていて、賢い受け答えより、相づちや間の取り方を体験するものと考えるのがよさそうです。電話番号は予告なく止まることがあります。
実際に電話した GIGAZINE は、会話に詰まる場面はあるものの、かなり自然な応答ができていたと伝えています(出典)。
GPU メモリが約12GB ある PC なら、ブラウザで話せる Web デモを動かせます。
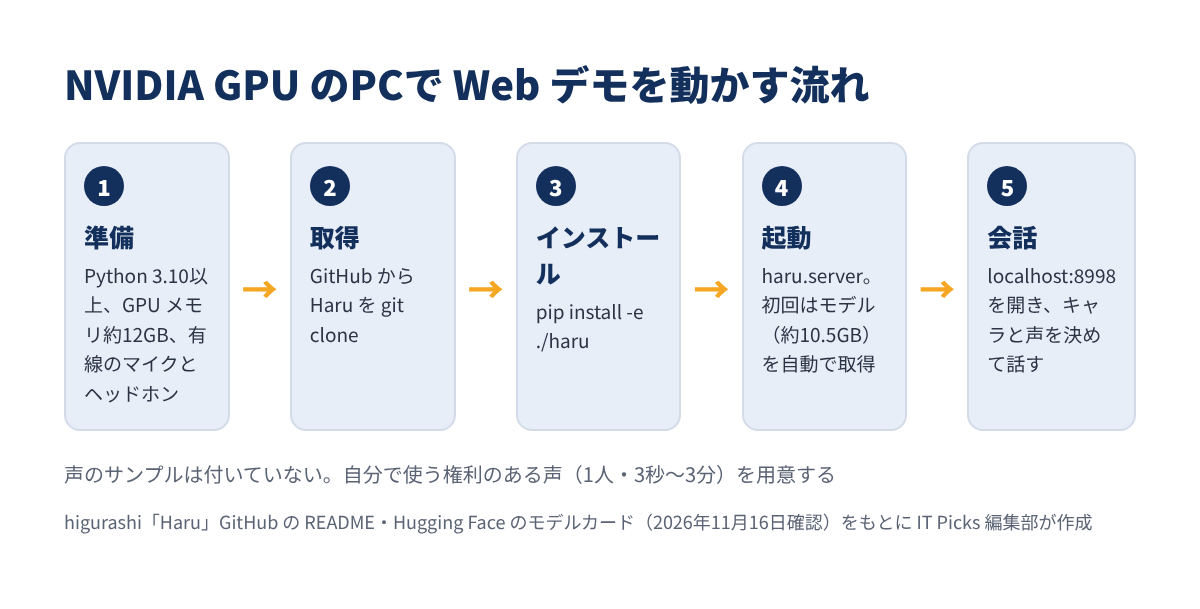
ターミナル(NVIDIA GPU の PC)
git clone https://github.com/higurashi-ai/Haru && cd Haru
pip install -e ./haru
python -m haru.server --hf-repo higurashi-ai/Haru-4B
起動したら、ブラウザで http://localhost:8998 を開き、キャラクターを選んで声を渡し、話しかけます。ブラウザがマイクを使わせるのは localhost か HTTPS のページだけなので、別の PC から開くときは注意が必要です。
ほかの人にも試してもらいたいときは、--share を付けると公開用の HTTPS のリンクが表示されます。
ターミナル(NVIDIA GPU の PC)
pip install -e "./haru[share]"
python -m haru.server --hf-repo higurashi-ai/Haru-4B --shareこの場合、リンクを知っている人は誰でもデモを使え、通信は Gradio の共有サーバーを通ります。社内のデータや他人の声を扱うときは使わないほうが安心です。
Mac では、Haru のフォルダの中の haru_mlx で、ネイティブアプリを自分でビルドします。
ターミナル(Mac)
cd haru_mlx
python3 -m venv .venv && source .venv/bin/activate
pip install -e .
cd swift && ./build_app.sh
open build/Haru.app
swiftc を使うため、先に Command Line Tools(xcode-select --install)を入れておきます。起動するとマイクの許可を求められるので、許可して話しかけます。
自分のアプリに組み込む場合は、Python からモデルを読み込み、133ミリ秒ずつ音声を渡して返事の音声を受け取ります。録音したファイルに返事をさせる haru-inference というコマンドもあります。
ターミナル(NVIDIA GPU の PC)
haru-inference user.wav reply.wav --reference voice.wav --system-prompt "$(cat card.txt)" --stereo2026年11月16日に、テスト用の Linux 環境(Docker、GPU なし)で、Haru のインストールとキャラクターカードの作成までを実際に動かしました。GPU が無いため、モデル本体(約10.5GB)の取得と会話はしていません。
GPU が無い環境なので、PyTorch は CPU 版を先に入れてから Haru を入れました。
ターミナル(テスト用の Linux)
git clone https://github.com/higurashi-ai/Haru && cd Haru
pip install torch --index-url https://download.pytorch.org/whl/cpu
pip install -e ./haru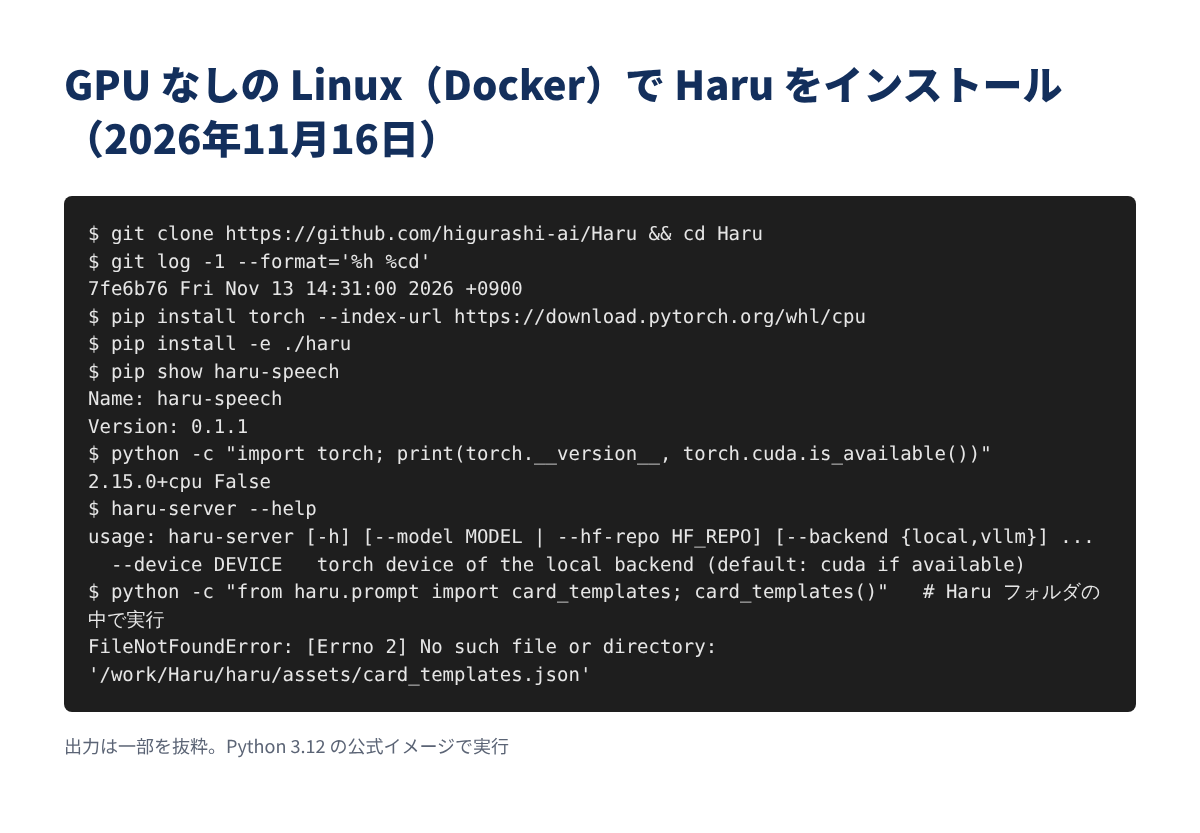
インストールは約29秒で終わり、パッケージ名は haru-speech 0.1.1 でした。haru-server --help を実行すると、使う装置は「cuda if available(GPU があれば GPU)」が既定だと表示されます。GPU なしで会話できるとは公式に書かれていないので、会話を試すなら表の条件を満たすマシンが必要です。
Haru が話す人物は、決まった形式のカードで渡します。日本語のテンプレートを使うと、次のように作れます。
card.py
from haru.prompt import card_templates, render_card

t = card_templates()["templates"]["ja"]
card = render_card({
    "persona": "ハルは東京に住む29歳の看護師。明るくて話し好きで、よく笑う。",
    "name": "ハル", "gender": "female", "backchannel": "high",
    "other_name": "サム",
    "relationship": "高校時代からの友人。",
    "situation": "久しぶりに近況を話す電話。",
}, t)
print(card)ここで1つつまずきました。Haru のフォルダの中(リポジトリの直下)で実行すると、テンプレートのファイルが見つからないというエラーになります。
実行結果(Haru のフォルダの中で実行)
FileNotFoundError: [Errno 2] No such file or directory: '/work/Haru/haru/assets/card_templates.json'同じ名前の haru フォルダが手前にあるため、Python が別の場所を見に行ってしまうのが原因です。別のフォルダに移ってから実行すると、日本語のカードが出力されました。
ターミナル(テスト用の Linux)
cd /tmp
python card.py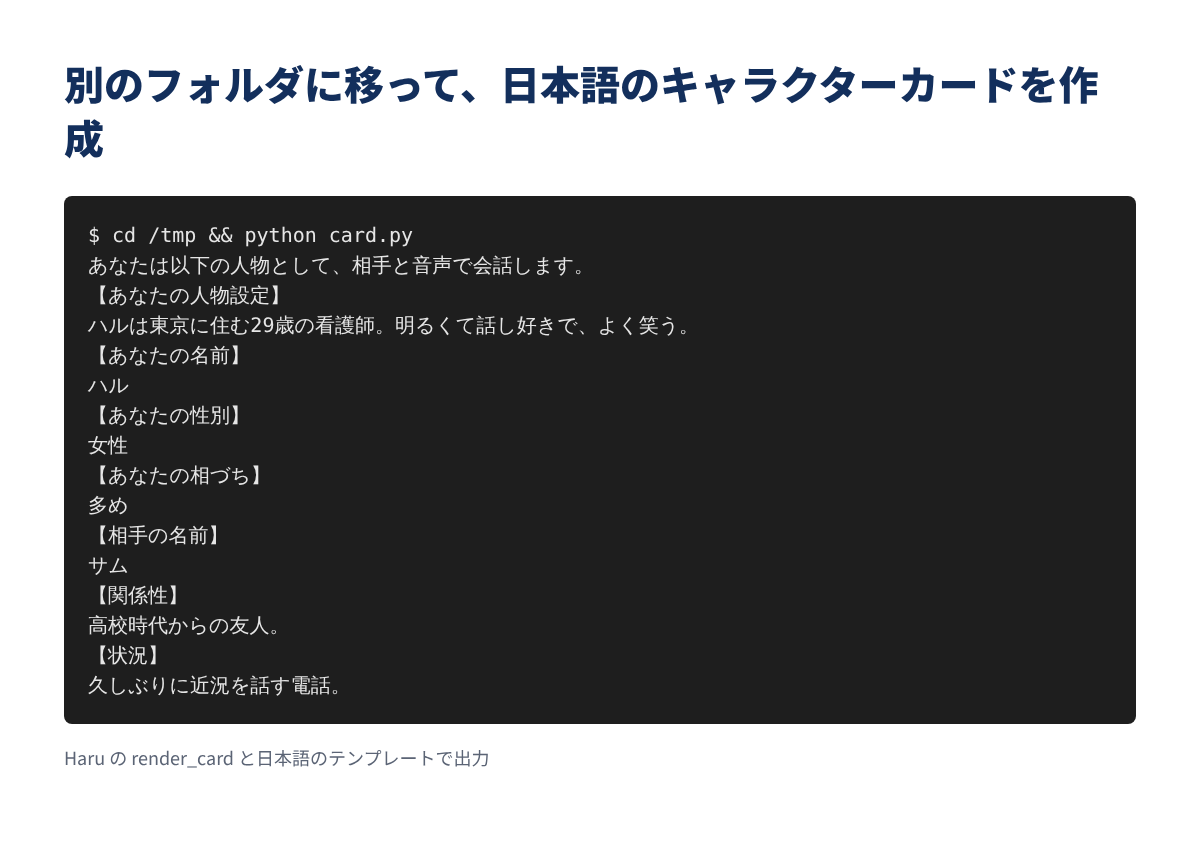
カードは「【あなたの人物設定】」「【あなたの相づち】」「【関係性】」などの見出しが並ぶ形です。相づちの量は「少なめ・普通・多め」の3段階で選べます。テンプレートは9言語分が入っていました。
この先の、モデルの取得・声の登録・会話は、上の「② NVIDIA GPU の PC で Web デモを動かす」の公式の手順になります。
Haru のコードと Haru-4B の重みは、どちらも Apache License 2.0 です。このライセンスは使い道を限っておらず、商用のサービスに組み込むことも禁じていません。ベースの Qwen3.5-4B も Apache 2.0 です。
| 確認すること | 内容 |
|---|---|
| 再配布するとき | ライセンスの写しを付ける・変更したファイルに変更を書く・著作権の表示を残す |
| 同梱の他社のコード | VibeVoice(Microsoft)・Moshi の Web クライアント(Kyutai)などは MIT ライセンス。THIRD_PARTY_NOTICES を確認 |
| 声 | 声のサンプルは同梱なし。使う権利のある声だけを参照音声にする |
| 中身の正確さ | 事実の情報源としては信頼できない(公式の制限) |
| 位置づけ | 研究用に公開した事前学習済みのベースモデル |
ライセンス上は商用で使えますが、そのままお客さま向けの窓口に置けるアシスタントではありません。公式も、指示に従う能力や正確さは保証していません。商用で使うなら、自分のデータで調整(ファインチューニング)し、答えの中身を別の仕組みで確かめる前提で考えるのが安全だと IT Picks は考えています。
他人の声をまねさせることは技術的にできてしまうため、本人の同意が無い声は使わないことが大切です。
Q. 無料で使えますか? A. モデルとコードは無料で公開されていて、利用料はかかりません。
Q. GPU が無い PC で会話できますか? A. 公式の手順は NVIDIA GPU(メモリ約12GB)か Apple シリコンの Mac が前提です。GPU なしで会話する手順は、公式には書かれていません。
Q. ChatGPT の音声モードの代わりになりますか? A. 目的が違います。Haru-4B は自然な会話のテンポを学んだベースモデルで、公式は事実の正確さや指示に従う力を保証していません。
Q. 日本語以外も話せますか? A. 英語・中国語・韓国語など9言語に対応しています。カードのテンプレートも9言語分あります。
音声 AI は「文字起こし → LLM → 読み上げ」をつなぐ形がまだ主流ですが、Haru-4B は会話のテンポそのものを1つのモデルで学ぶ方向を、日本のチームが商用利用もできる形で出した点に意味があると考えています。電話デモで、誰でもすぐ体験できるのも親切です。
一方で、公式が自ら「GPT2 程度の知性」と書くとおり、今はまだ中身より「話し方」の土台です。higurashi は100B を超える大きなモデルの事前学習を進めていて、テクニカルレポートと学習コードも公開する予定としています。会話の自然さと賢さがそろったとき、コールセンターや見守り、語学の練習相手などで使える場面が一気に広がりそうで、続報を待ちたいところです。
端末の中で動く AI に興味がある人は、Chrome の中だけで翻訳する拡張機能の記事もあわせてどうぞ。
大手の音声 AI の日本語対応の流れは、Siri AI の日本語対応の記事や、会議の声を訳す Google Meet の記事で紹介しています。
Haru-4B のポイントをまとめます。
まずは電話デモで「自己紹介をお願いします」と話しかけて、相づちのテンポを体験してみてください。