CVE-2026-98432、Ubuntuの対象と更新【2026年10月】
IT Picks編集部
IT Picks
Google が、通称「SRE本」こと『Site Reliability Engineering』の第2版を発表しました。2026年10月12日の Google Cloud 公式ブログで、初版から10年の節目に「完全に書き直した(completely rewritten)」と説明しています。
第2版では、10年で変わった運用の実践に加え、AI とどう付き合うかが大きなテーマになりました。サーバーやサービスを「止めずに動かす」ための考え方を、クラウドと AI の時代向けに更新した一冊という位置づけです。
この記事はこんな人向けです
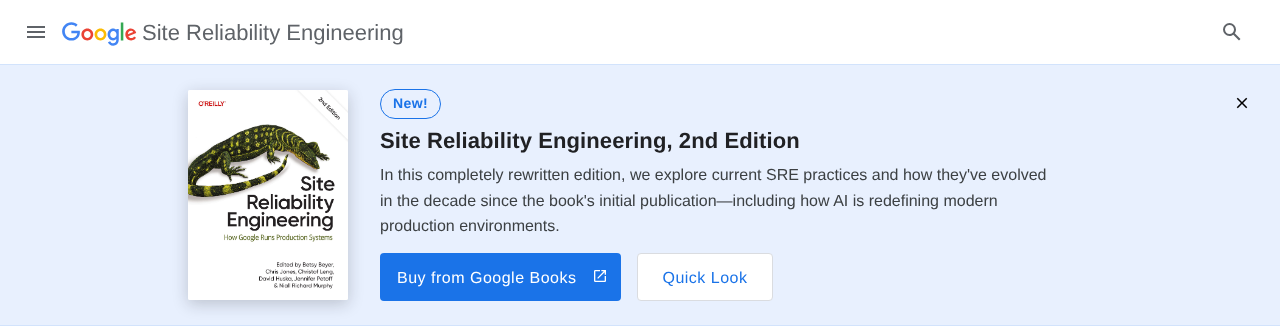
Google の SRE チームが、自社の運用のやり方を10年分の経験をもとに書き直した本です。sre.google の書籍ページでは「New!」の表示とともに紹介されています。
| 項目 | 2026年11月6日時点で分かっていること |
|---|---|
| 書名 | Site Reliability Engineering, 2nd Edition |
| 発表 | 2026年10月12日(Google Cloud ブログ) |
| 位置づけ | 初版から10年を機に完全に書き直した第2版 |
| 編者 | Betsy Beyer、Chris Jones、Christof Leng、David Huska、Jennifer Petoff、Niall Richard Murphy |
| 主な新しい内容 | 信頼性の価値、クラウドの信頼性、AI の影響 |
| 入手方法 | 紙は Google Books、電子版は O’Reilly から注文 |
| 無料のオンライン版 | 第2版は案内なし(初版は sre.google で無料公開中) |
sre.google の紹介文は、第2版で新しく扱うものを「信頼性の価値、クラウドの信頼性、AI の影響」とまとめています(出典)。
SRE(サイトリライアビリティエンジニアリング)は、Google が広めたシステム運用の考え方です。sre.google は SRE を「運用をソフトウェアの問題として扱ったときに生まれるもの」と説明しています(出典)。
手作業の運用をプログラムで自動化し、どこまでの停止なら許せるか(SLO)を数字で決めて、開発の速さと安定性のバランスを取る——というのが代表的な考え方です。
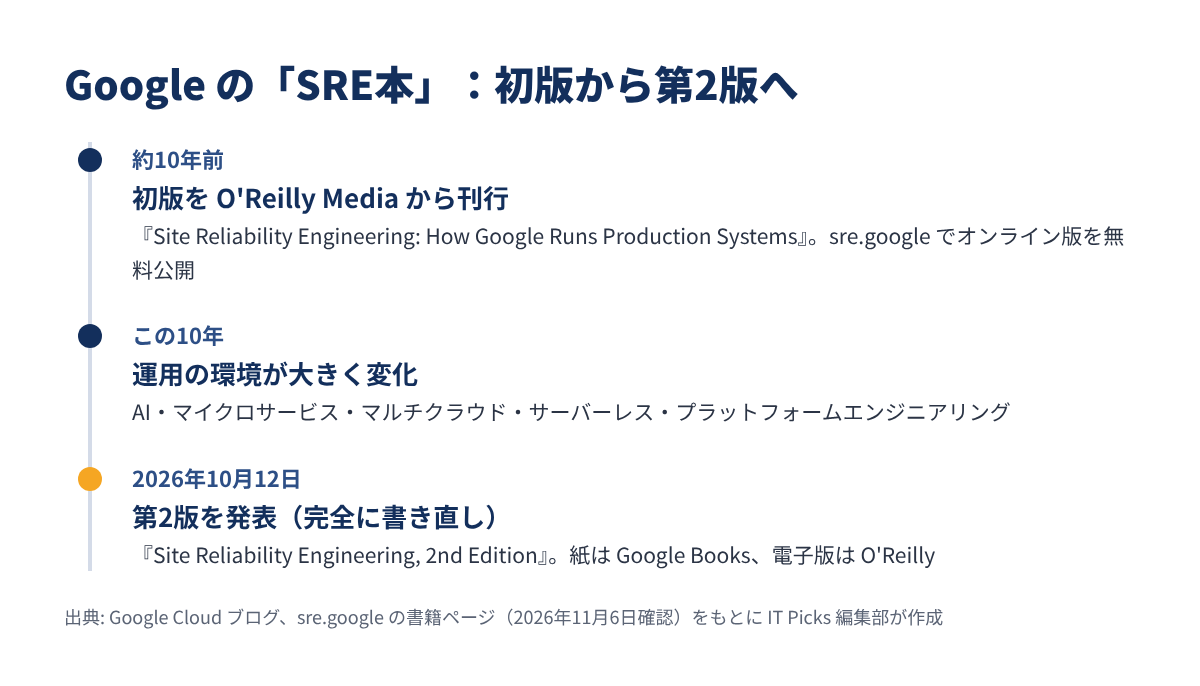
Google Cloud ブログによると、Google は10年前に O’Reilly Media から初版『Site Reliability Engineering: How Google Runs Production Systems』を出しました(出典)。ブログは、初版がベストセラーになり、多くの組織が SRE を取り入れるきっかけになったと振り返っています。
ブログは、この10年でAI・マイクロサービス・マルチクラウド・サーバーレス・プラットフォームエンジニアリングが、ソフトウェアの作り方と運用を大きく変えたと書いています。
初版のころはクラウドへの移行を始めたばかりの組織が多かった一方、今の課題は「クラウドを導入することではなく、とても複雑になった環境で高い信頼性を保つこと」だ、という説明です(出典)。
Google Cloud ブログは、SRE の基本的な実践が「手作業・個別の作業」から「自動化・プラットフォーム全体の仕組み」へ移ったとして、6つの例を挙げています(出典)。
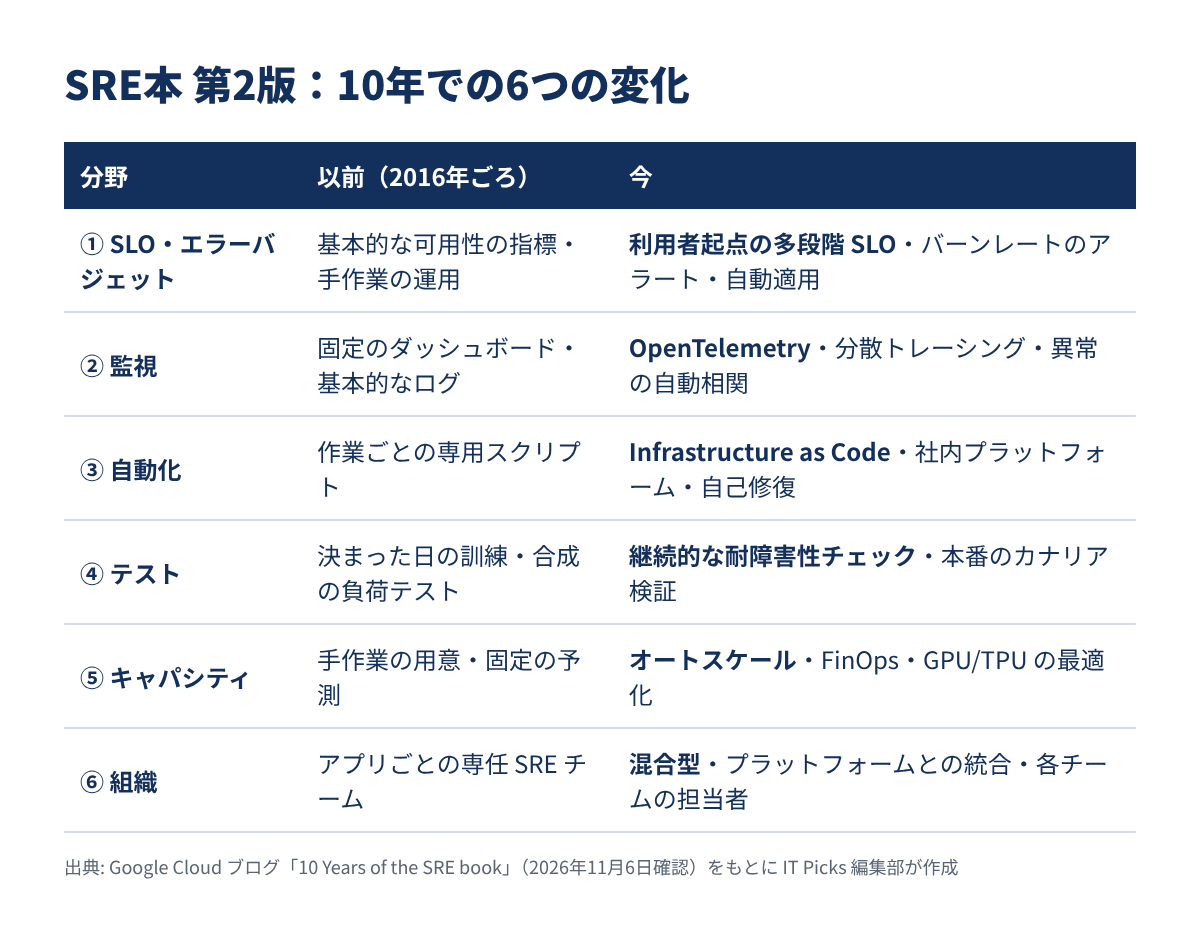
2016年当時は、基本的な可用性の指標と、手作業のエラーバジェットの運用が中心でした。今は利用者を起点にした多段階の SLO、バーンレート(予算を使う速さ)にもとづくアラート、ポリシーの自動適用へと進んだ、とブログは書いています。
以前は固定のダッシュボード・基本的なログ・手作業のアラート対応が中心でした。今は OpenTelemetry・分散トレーシング・異常の自動相関で、原因を素早く見つける形になったと説明しています。
個別の作業ごとに専用のスクリプトを書くやり方から、宣言的な Infrastructure as Code・社内の開発者向けプラットフォーム・自己修復するシステムへ移ったとしています。
決まった日に行う訓練(game day)や合成の負荷テストだけに頼らず、継続的な耐障害性のチェック・パイプラインでの自動テスト・本番でのカナリア検証を組み込む形になった、という説明です。
手作業でのサーバーの用意や固定の予測に代わり、動的なオートスケール・クラウドの FinOps(コスト管理)との連携・GPU や TPU の処理に向けたコストとクラスタの最適化が使われるようになったとしています。
SRE は、特定のアプリを受け持つ専任チームだけのものではなくなりました。混合型の体制、プラットフォームエンジニアリングとの統合、各プロダクトチームに置く「信頼性の担当者」などの形が使われている、とブログは書いています。
第2版の大きなテーマが AI です。Google Cloud ブログは、SRE と AI の関係を「SRE が AI 基盤を支える」「SRE が AI を使って信頼性を高める」の2方向で説明しています(出典)。
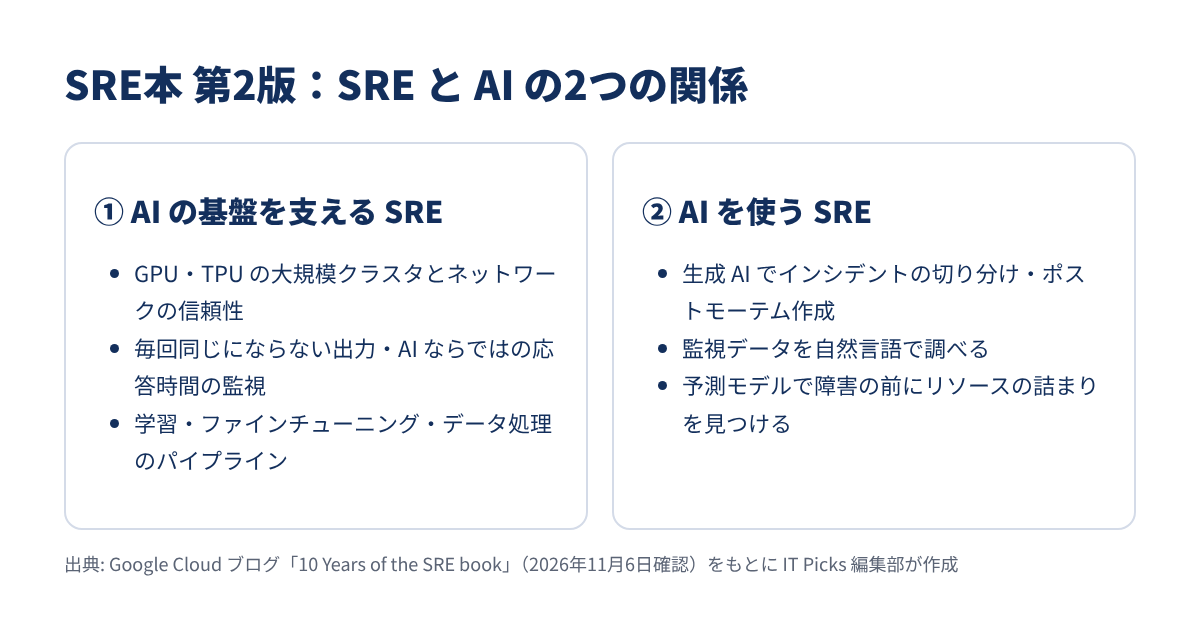
大規模言語モデル(LLM)を動かすには、これまでにない信頼性の課題があるとして、本では次のような方法を紹介しているとしています。
反対に、AI は SRE の作業を大きく助ける道具にもなっています。第2版では、次のような使い方の枠組みを紹介しているとしています。
一方で、ブログは「技術や構成は変わり続けても、SRE の基本原則は変わらない」と書いています(出典)。
そのため第2版では、システムを支える「人」と文化の面を改めて強調し、内容を広げたとしています。対象の読者として、ブログはSRE を始めたばかりの人・実務者・エンジニアリングマネージャー・技術系の経営層を挙げています。
2026年11月6日時点の sre.google の書籍ページでは、第2版には「Buy from Google Books」のリンクだけがあり、オンラインで無料で読むリンクはありません(出典)。Google Cloud ブログも、紙の本は Google Books、電子版は O’Reilly で注文できると案内しています(出典)。
| 本 | sre.google での扱い(2026年11月6日時点) |
|---|---|
| Site Reliability Engineering, 2nd Edition | 購入のみ(Google Books へのリンク) |
| Site Reliability Engineering(初版) | オンラインで無料で読める |
| The Site Reliability Workbook | オンラインで無料で読める |
| Building Secure & Reliable Systems | オンラインで無料で読める |
初版は今も sre.google で無料公開されています(初版のオンライン版)。オンライン版には CC BY-NC-ND 4.0 のライセンスが示されています。実践編の『The Site Reliability Workbook』(オンライン版)と、セキュリティを扱う『Building Secure & Reliable Systems』(オンライン版)も無料で読めます。
第2版の価格・ページ数・章の一覧・日本語版の予定は、Google の公式ページでは確認できませんでした。購入する前に、販売ページで最新の情報を確かめてください。
発表は Hacker News でも話題になりました(スレッド)。以下はいずれも個人の投稿です。
第2版は、SRE の考え方そのものを変えるというより、10年で当たり前になった道具と体制に合わせて「教科書」を更新したものだと受け止めています。SLO・監視・自動化といった基本はそのままに、OpenTelemetry やプラットフォームエンジニアリング、AI まで含めたのは、今の現場に近い内容と言えそうです。
特に、「AI を動かすための SRE」と「AI を使う SRE」の両方を扱う点は、AI を自社のサービスに組み込み始めたチームにとって参考になるはずです。AI の基盤の信頼性は、Workers AI で他人のデータが混ざった件のように、すでに現実の問題になっています。
一方で、第2版は今のところ購入のみです。まずは無料で読める初版で基本の考え方を押さえ、変わった部分を第2版で確かめる——という読み方が、これから学ぶ人には手軽だと思います。大規模な障害や攻撃への備えは、Cloudflare の DDoS レポートのような事例とあわせて読むと理解しやすくなります。
Google の SRE本 第2版のポイントをまとめます。
第2版が気になる人は、まず sre.google の初版のオンライン版を開いて、SLO やポストモーテムの章から読み直してみてください。