Model Spec改訂でChatGPTはどう変わる?【2026年10月】
IT Picks編集部
IT Picks
「API で高いモデルを指定したのに、裏で安いモデルに差し替えられていたら?」——今は、利用者がそれを確かめる手段がほとんどありません。
2026年11月2日、Anthropic は AI の応答が「特定のモデル」から出たことを暗号技術で証明する仕組み「FlashProve」を、研究用のプロトタイプとして公開しました。開発したのは Anthropic の Frontier Red Team で、EPFL・MIT などの研究者が共著者に入っています。
ポイントは、モデルの重み(中身)を明かさずに、「この応答はこのモデルが出した」と第三者が確かめられる点です。コードは Apache 2.0 のオープンソースで公開されています。
この記事はこんな人向けです
AI の提供者が「この応答は、事前に登録したこのモデルが出したもの」という証明を付け、利用者が重みなしで検証できるようにする仕組みです。
| 項目 | 内容 |
|---|---|
| 何を証明する | 応答のトークンが、登録(コミット)したモデルを動かした結果であること |
| 方式 | zkSNARK(ゼロ知識の簡潔な証明)。重み・中間の計算・どの専門家が動いたかは明かさない |
| 実験したモデル | Llama 4 Maverick(4ビットの公開重み、MoE 型) |
| 検証に要るもの | CPU だけ(GPU 不要)。24スレッドで17秒 |
| 公開の形 | Apache 2.0 のコード・技術レポート・Lean の証明。研究用のプロトタイプ |
「ゼロ知識」は、正しいことだけを示し、それ以外の情報は何も漏らさない証明のことです。重みを秘密にしたいクローズドなモデルでも使える形を目指しています。
公式ブログは出発点として、今の利用者は、応答が本当にそのモデルから来たのかを確かめられないことを挙げています。例として挙げているのが、ルーティングのサービスがコストのためにこっそり別のモデルに差し替えるケースです。
技術レポートも、提供者が宣言より小さい・弱いモデルを使ったり、リクエストごとにモデルを切り替えたりしても利用者には分からない、と説明しています。重みを公開すれば確かめられますが、多くの提供者は重みを秘密にしており、利用者が自分で巨大なモデルを動かすのも現実的ではありません。
公式ブログが挙げる使い道は次のとおりです。
提供者が先にモデルの「封印」を公開し、応答ごとに証明を付け、利用者が手元で確かめる、という流れです。
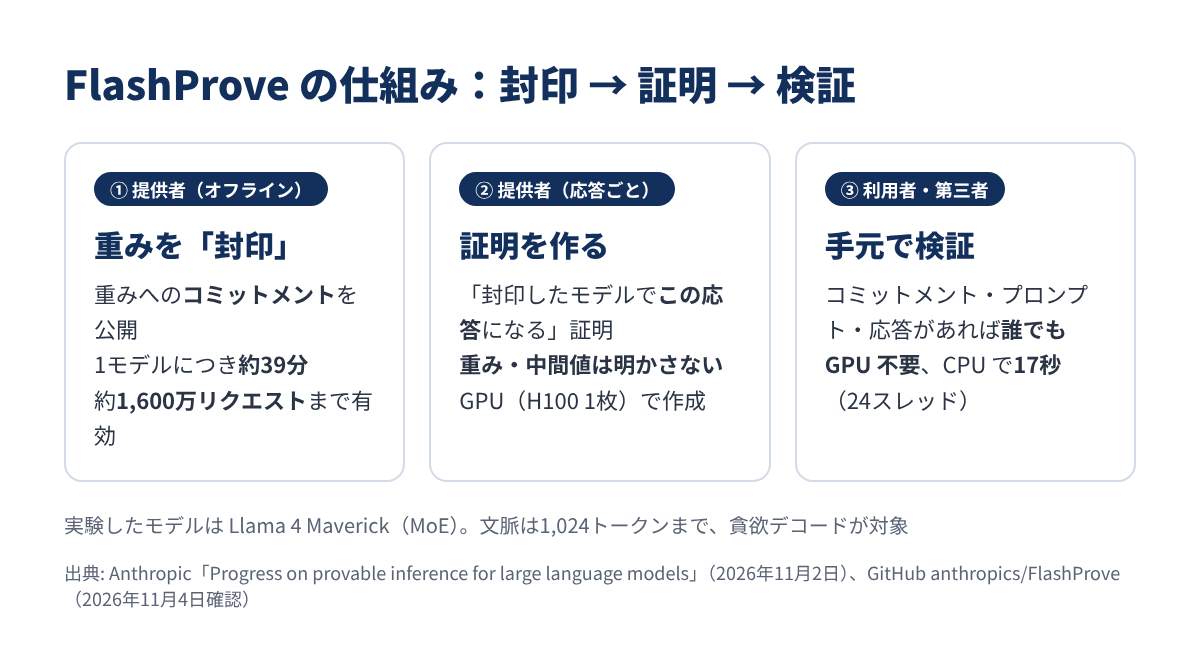
提供者はオフラインで、モデルの重みに対するコミットメント(中身を明かさずに「この重みで固定した」と約束する短いデータ)を公開します。この作業は1モデルにつき約39分で、1つのコミットメントで約1,600万リクエストまで使えます。
利用者のリクエストに答えるたびに、提供者の GPU が「コミットしたモデルを評価すると、この出力トークンになる」という証明ファイルを作ります。証明は重み・中間値・どの専門家(expert)が動いたかを明かしません。
コミットメント・プロンプト・応答を持っていれば、誰でも重みなしで検証できます。検証器は GPU 不要で、公式の計測では 24スレッドで17秒、1スレッドでも21秒。クライアントが取得するコミットメントのデータは約6.5MBです。
GitHub の README は、コミットメントの ID は検証される側のサーバーからではなく、信頼できる相手から受け取るよう案内しています。
公式は Llama 4 Maverick(約4,000億パラメータの MoE。1トークンあたり約170億が動く)で性能を測っています。
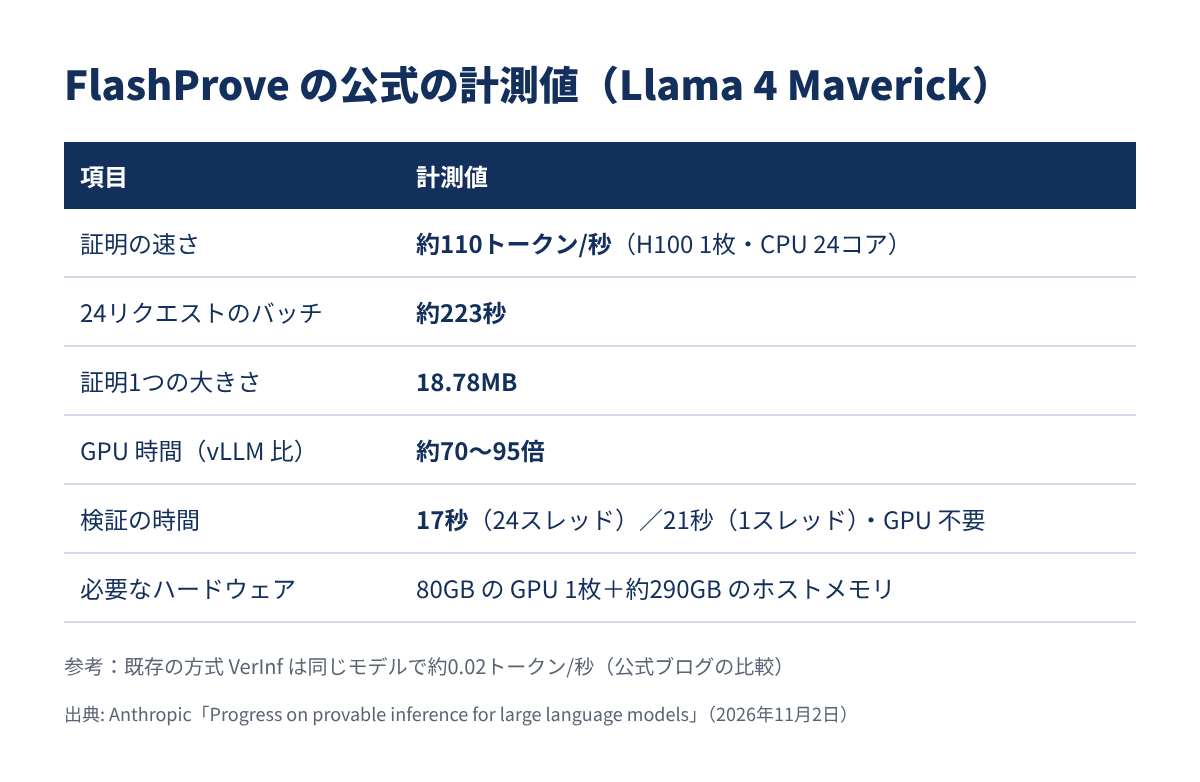
| 項目 | 公式の計測値 |
|---|---|
| 証明の速さ | 約110トークン/秒(H100 1枚・CPU 24コア) |
| 24リクエストのバッチ | 約223秒 |
| 証明1つの大きさ | 18.78MB |
| GPU 時間(vLLM 比) | 約70〜95倍(約2桁) |
| 検証の時間 | 17秒(24スレッド)/21秒(1スレッド) |
| 必要なハードウェア | 80GB の GPU 1枚+約290GB のホストメモリ |
公式ブログは、同じモデルで既存の方式(VerInf)は約0.02トークン/秒だったと比べています。数桁速くなったとはいえ、普通に推論するより GPU 時間が約70〜95倍かかるので、すぐにすべての応答に付けられるコストではありません。
コードは誰でも入手できますが、証明を作るのはモデルの提供者側です。利用者は、提供者が証明を付けてくれれば手元で検証できます。
| 役割 | できること | 必要な環境(GitHub README) |
|---|---|---|
| 検証する人(利用者) | 証明が正しいかを確かめる | Linux・g++ 13 以上・2GB 未満のメモリ。ビルドは1〜2分 |
| 証明を作る人(提供者) | コミットメントと証明を作る | x86-64 Linux・専用の H100 80GB・CUDA 13.2。Maverick では330GB のメモリ・245GB のディスク |
※ 2026年11月4日時点の公式ブログ・GitHub の内容です。
公式ブログは「研究用のプロトタイプ」として、次の制限を明記しています。
サンプリングで応答を作る一般的な使い方や、長い文脈は、現時点ではそのまま対象にならない点に注意が必要です。
海外の開発者コミュニティ Hacker News では、11月3日に公式ブログが2回(9ポイント・6ポイント)、GitHub リポジトリが1回(1ポイント)投稿されましたが、11月4日時点ではいずれもコメントは付いていません(出典)。
公開から日が浅く、議論はこれからといえます。日本では GIGAZINE や ITmedia AI+ が11月4日に取り上げています。
API の利用が広がるほど、「本当に指定したモデルが答えているのか」は気になる点です。とくに複数のモデルを束ねるルーティングのサービスや、安い互換 API では、利用者に確かめる手段がありませんでした。FlashProve は、そこに暗号で答えを出せることを、4,000億パラメータ級のモデルで示した点に意味があると思います。
一方で、GPU 時間が約70〜95倍、文脈は1,024トークンまで、サンプリングは対象外と、今の商用の使い方にそのまま当てはめるには距離があります。公式も「研究用のプロトタイプ」「メンテナンスしない」としており、今日から使うツールというより、業界に向けた技術の提示と受け止めるのがよさそうです。
規制当局が「承認済みのモデルだけが動いているか」を確かめる用途にも触れている点は、AI の規制が進むなかで注目したいところです。上場を申請した Anthropic が、安全性の研究を公開し続ける姿勢も読み取れます。
モデルを安く使い分ける動きが進むほど、「どのモデルが答えたか」の確かめ方は重要になりそうです。
FlashProve のポイントをまとめます。
仕組みを詳しく知りたい開発者は、まず公式ブログと GitHub の READMEを読んでみてはいかがでしょうか。用途に合わせたモデルの選び方は、ChatGPT・Claude・Gemini の使い分けも参考にしてください。