ConoHa VPSとは?料金・特徴・できることを初心者向けにまとめて解説【2026年版】
itpicks_admin
IT Picks
自分のブログの記事を AI の学習に使われたくない——そう考えて、robots.txt に GPTBot などのクローラー名を一つずつ書き足してきた人には、関係の深い発表です。
2026年10月30日(米国時間)、OpenAI は robots.txt に書く「共通のシグナル」で示された AI 学習についての意思表示を尊重すると発表しました。サイトの管理者は、参加する複数の AI 企業に同じ意思表示を一度に伝えられるようになります。
同じ日には Google と Microsoft も同じ仕組みへの対応を発表しています。AI 企業ごとのクローラー名を追いかける運用から、共通の1グループで意思を示す運用へ——その入り口となる発表という位置づけです。ただし、OpenAI の対応は「今後数か月」の予定で、まだ始まっていません。
この記事はこんな人向けです
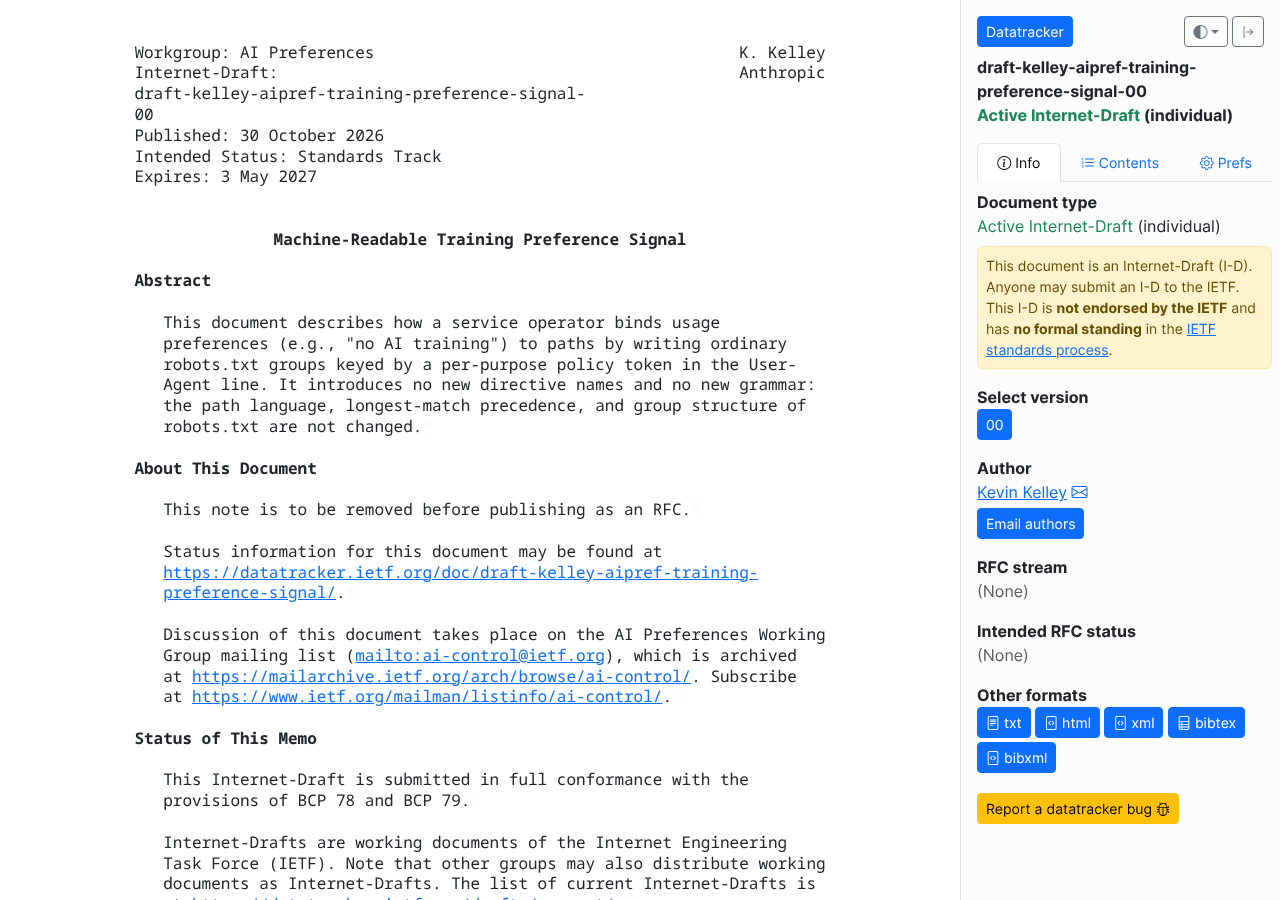
robots.txt の User-Agent 行に __usage_ai-training という共通の名前を書き、その下の Disallow / Allow で「AI の学習に使ってよいか」を示す仕組みです。OpenAI が発表で「signal」としてリンクしているのは、IETF に提出された Internet-Draft(標準化の議論のための草案)です。
| 項目 | 内容 |
|---|---|
| 発表日 | 2026年10月30日(米国時間、OpenAI 公式) |
| 何を伝えるか | 生成 AI の基盤モデルの学習に内容を使ってよいか |
| 書く場所 | robots.txt(新しいファイル・新しい書式は不要) |
| 共通の名前 | __usage_ai-training(ドラフトでは「policy token」) |
| 根拠の文書 | Internet-Draft「Machine-Readable Training Preference Signal」-00 版(2026年10月30日) |
| 標準化の状況 | 個人提出のドラフト。IETF の承認は受けていない |
| OpenAI の対応 | 「in the coming months(今後数か月)」に実装予定。詳細は実装時に公表 |
| 今の GPTBot などの設定 | そのまま有効(置き換えない) |
OpenAI は、この取り組みが任意(voluntary)であることも明記しています。法律で決まった仕組みではなく、参加する AI 企業が自主的に守る約束です(OpenAI)。
OpenAI は、これまでの状況を「クローラーを一つずつ特定し、提供者ごとに別のルールを管理する必要があった」と説明しています。AI 企業が増えるたびに、robots.txt に新しい名前を書き足す必要があったわけです。
共通のシグナルを使えば、__usage_ai-training のグループを1つ書くだけで、対応している企業すべてに同じ意思表示が届きます。
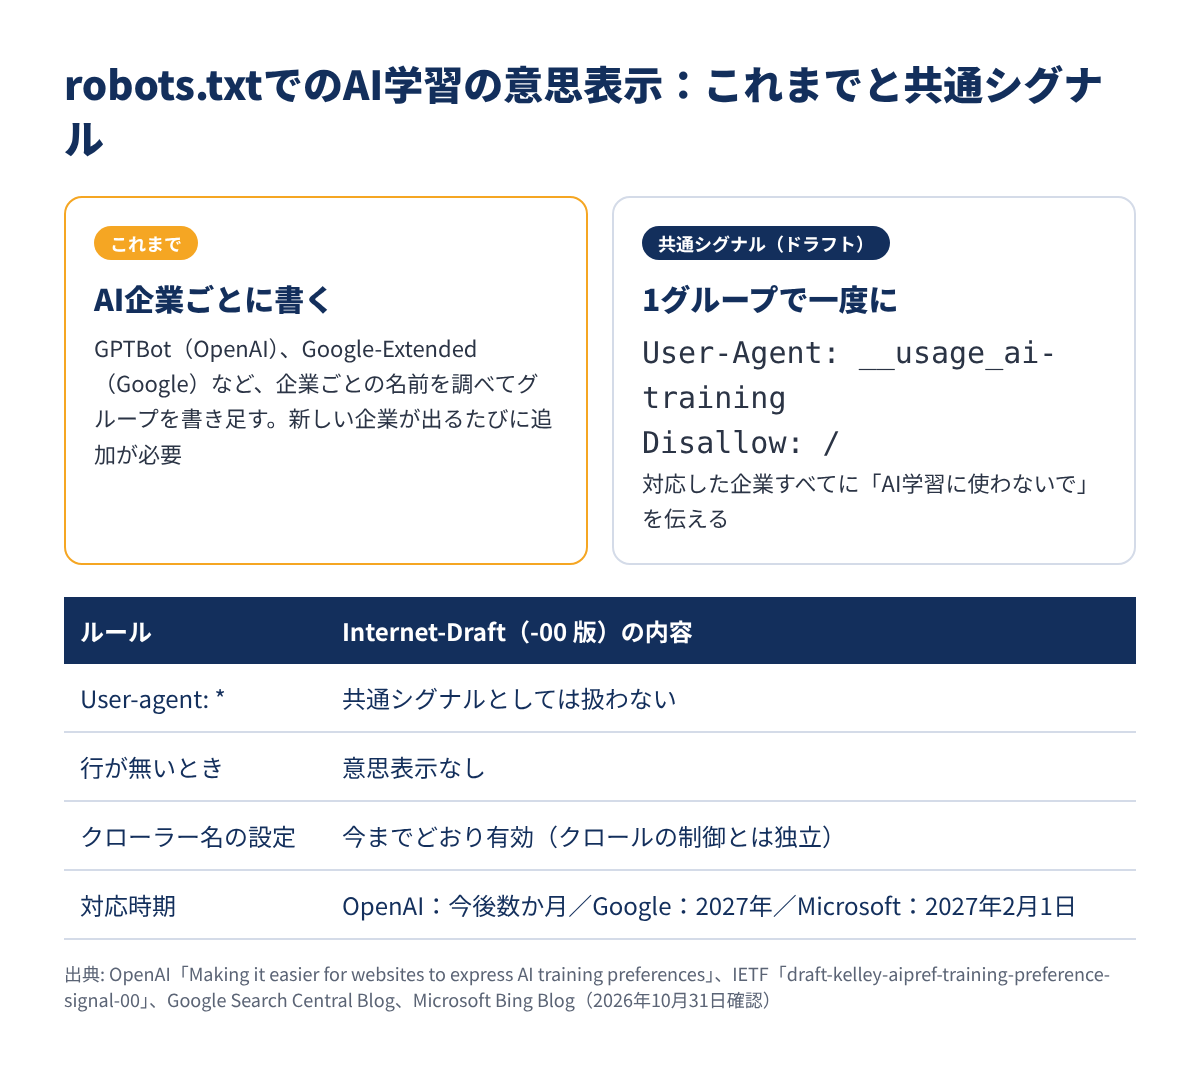
もう一つの違いは、「学習に使うか」と「クロールしてよいか」を分けて書けることです。これまで OpenAI に学習を断る方法は、GPTBot を Disallow する——つまりクロールそのものを断ることでした。共通シグナルは、「来てもいいが、学習には使わないで」という意思を表すためのものです。この点は次の節で詳しく見ます。
ここで紹介する書き方は、Internet-Draft(-00 版)と、それを紹介した Microsoft の公式ブログに載っている例だけです。ドラフトは今後変わる可能性があります。
ドラフトの最初の例(Figure 1)は次のとおりです。
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
これは、/press-kit/ 以外のすべてのページは AI 学習に使わないでほしい、/press-kit/ の下は使ってよい、という意味になります。パスの書き方や「一番長く一致したルールが優先」という決まりは、今の robots.txt(RFC 9309)のままです(Internet-Draft)。
サイト全体で学習を拒否する場合は、Microsoft の公式ブログに次の例があります。
User-Agent: __usage_ai-training
Disallow: /
(出典:Microsoft Bing Blog)
注意したいのが、User-Agent: *(すべてのクローラー向け)のグループは、このシグナルとして扱わないというルールです。ドラフトは「MUST NOT」(してはならない)と書いています。
つまり、User-agent: * に Disallow: / と書いていても、それはクロールの指定であって、AI 学習の意思表示にはなりません。学習について意思を示すには、__usage_ai-training の行を明示的に書く必要があります。
robots.txt に User-Agent: __usage_ai-training の行が1つも無ければ、意思表示はしていない扱いです。Microsoft は、何も書かない場合の既定を Allow(学習に使ってよい)としています(Microsoft Bing Blog)。
ドラフトは、このトークンはクロールの指示ではないと明記しています。各社のクローラー名(GPTBot など)に書いたルールはこれまでどおり解釈され、学習の意思表示とクロールの制御は互いに独立です。
アクセスそのものを止めたい場合は、従来どおりクローラー名のグループで制限するよう案内されています。また、個別の契約はこの意思表示より優先できるとも書かれています。
OpenAI の発表は「ワーキンググループの他の参加者とともに」発表したと書いていますが、参加企業の名前は挙げていません。同じ日に自社の公式ページで対応を発表したことを確認できたのは、次の3社です。
| 企業 | 発表(2026年10月30日) | 対応時期 |
|---|---|---|
| OpenAI | 共通シグナルを尊重する | 今後数か月(詳細は実装時に公表) |
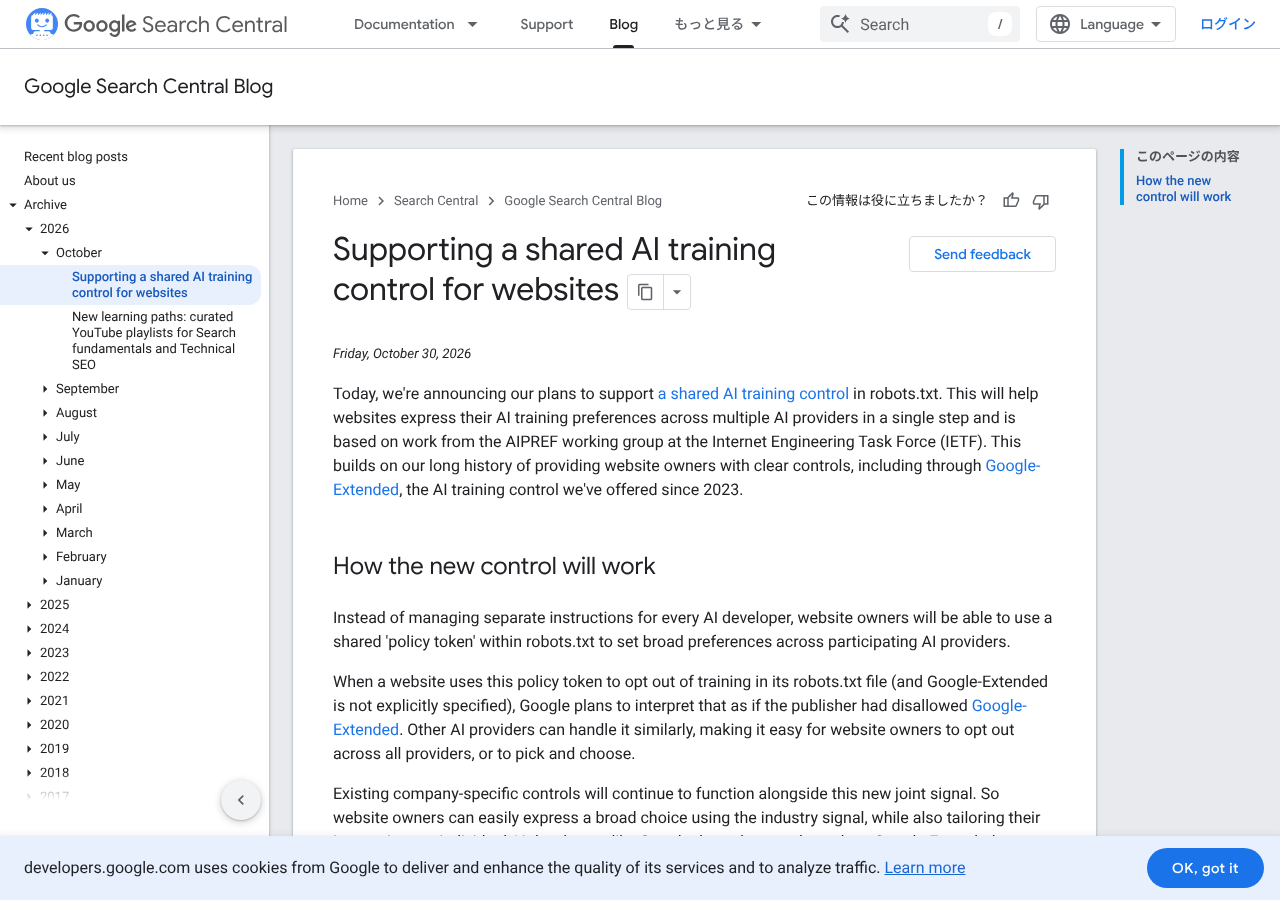
| 共有の AI 学習の制御に対応する計画 | 2027年を目指す | |
| Microsoft(Bing) | 共有の AI Training の意思表示に対応 | 2027年2月1日からクロール時に反映 |
Google は、共通シグナルで学習を拒否し、Google-Extended を個別に指定していない場合は、Google-Extended を Disallow したのと同じに扱う予定だとしています。Google-Extended は2023年から提供している AI 学習用の指定です。Google は今回の仕組みを「draft proposal(草案)」と呼んでいます(Google Search Central Blog)。
Microsoft は robots.txt に加えて、ページ単位のメタタグや HTTP ヘッダーで上書きできるようにし、AI の回答の根拠に使うか(AI Grounding)の設定も別に用意すると発表しています。学習の設定は、Bing の通常の検索結果に影響しないとしています(Microsoft Bing Blog)。
なお、ドラフトの著者は Anthropic の Kevin Kelley 氏です。ただし、Anthropic 自身の対応時期を示す公式発表は、2026年10月31日時点で見つけられませんでした。ほかの AI 企業の対応も、公式の発表を待つ必要があります。
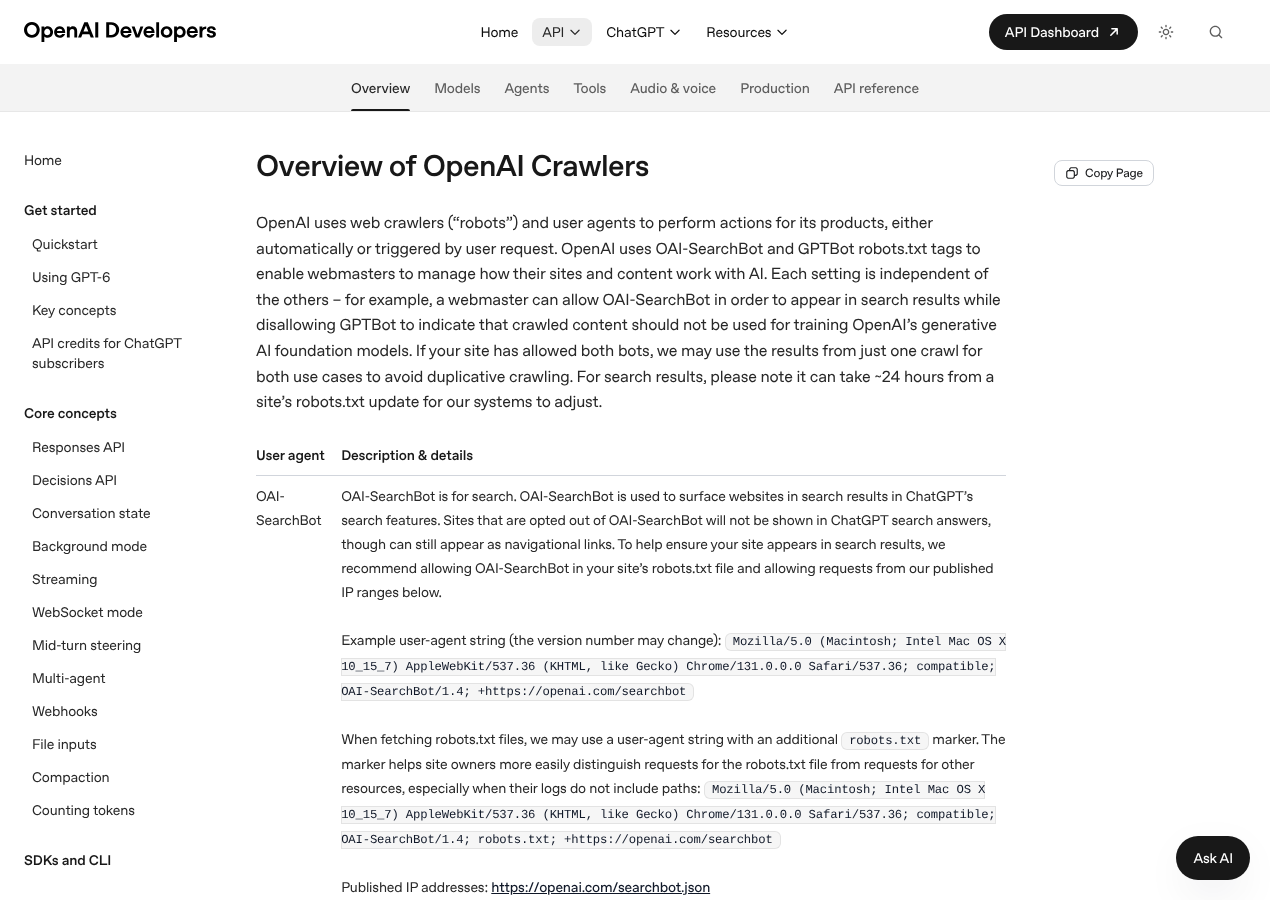
共通シグナルは、OpenAI ではまだ使えません。今 OpenAI に学習の意思を伝える方法は、これまでどおりクローラー名での指定です。OpenAI は、既存の制御は引き続き適用・尊重すると明言しています。
| クローラー | 役割 | robots.txt で拒否すると |
|---|---|---|
| GPTBot | 生成 AI の基盤モデルの学習に使われうる内容を集める | 学習に使わないでほしいという意思表示になる |
| OAI-SearchBot | ChatGPT の検索にサイトを表示する | ChatGPT の検索の回答に表示されなくなる(ナビゲーションのリンクには出ることがある) |
| ChatGPT-User | ユーザーの操作でページを訪れる | 自動のクロールには使わず、robots.txt が適用されない場合がある |
ポイントは、GPTBot と OAI-SearchBot の設定はそれぞれ独立していることです。OpenAI は「OAI-SearchBot を許可して検索に出しつつ、GPTBot を拒否して学習には使わせない」という使い分けの例を挙げています。検索への反映には、robots.txt の変更から約24時間かかるとしています(OpenAI「Overview of OpenAI Crawlers」)。
OpenAI が AI モデルの振る舞いについて公開している指針「Model Spec」の改訂は、こちらで解説しています。
WordPress には robots.txt を自動で出力する仕組み(do_robots)があります。公式リファレンスによると、既定の中身は User-agent: * のグループに、管理画面(/wp-admin/)の Disallow と admin-ajax.php の Allow を書いたものです(WordPress「do_robots()」)。
ドラフトのルールに当てはめると、この既定のままでは AI 学習についての意思表示はしていないことになります。User-agent: * は対象外で、__usage_ai-training の行も無いためです。
学習を拒否したい場合に今やっておくことを整理します。
https://自分のドメイン/robots.txt を開き、何が書かれているかを見るWordPress 本体の更新も、サイト運営では欠かせません。直近の脆弱性の修正はこちらでまとめています。
今回の仕組みを使ううえで、知っておきたい点が3つあります。
IETF の Datatracker は、このドラフトを「個人(individual)」の提出と表示し、「not endorsed by the IETF(IETF の承認を受けていない)」「標準化の過程で正式な位置づけはない」と明記しています。土台になっている aipref ワーキンググループの語彙のドラフトも、まだ RFC(正式な標準)にはなっていません(IETF Datatracker)。
OpenAI 自身が「voluntary(任意)」と書いているとおり、守るのは対応を表明した企業だけです。対応していないクローラーには、これまでどおりクローラー名での指定やサーバー側でのブロックが必要です。
ドラフトの「AI Training」は、生成 AI モデルの学習済みのパラメーターを変えるための利用と定義されています。生成以外のタスク専用のモデルの学習は含まないとされています。また、適用されるのはその内容を取得した時点の robots.txt の意思表示です(Internet-Draft)。
発表の翌日の2026年10月31日時点では、目立った議論はまだ起きていません。Hacker News には OpenAI の発表が投稿されていますが、コメントは Google の関連発表を紹介する1件だけです(Hacker News)。Google の発表の投稿もコメントは0件でした(Hacker News)。
実際の効果が話題になるのは、各社が対応を始めてからになりそうです。
今回の発表は、サイト運営者にとって「AI 企業の名前を覚えて追いかける」負担を減らす一歩だと受け止めています。OpenAI・Google・Microsoft が同じ日に足並みをそろえたことで、共通シグナルが事実上の標準になる可能性も出てきたと考えています。
特に良いと感じるのは、「クロールは許可するが学習は断る」を素直に書けることです。これまでは、学習を断るためにクローラーごと締め出し、検索や AI の回答からも見えにくくなる心配がありました。
一方で、OpenAI の対応はまだで、ドラフトの書き方も変わりうる段階です。慌てて robots.txt を書き換える必要はなく、当面は GPTBot などの既存の設定を確認しておくのが現実的でしょう。OpenAI が実装の詳細を公表するのを待ちたいところです。
AI のクローラーに限らず、サイトへの不要なアクセスを減らすには、WAF の活用も選択肢になります。無料で使える範囲はこちらで整理しています。
OpenAI の共通 AI 学習シグナルへの対応のポイントをまとめます。
User-Agent: __usage_ai-training のグループに Disallow / AllowUser-agent: * は対象外、書かなければ意思表示なしまずは自分のサイトの robots.txt を開いて、GPTBot などの今の設定を確認しておくところから始めてみてください。