Cloudflare OSにマネージド版、GitHub連携も【2026年10月】
IT Picks編集部
IT Picks
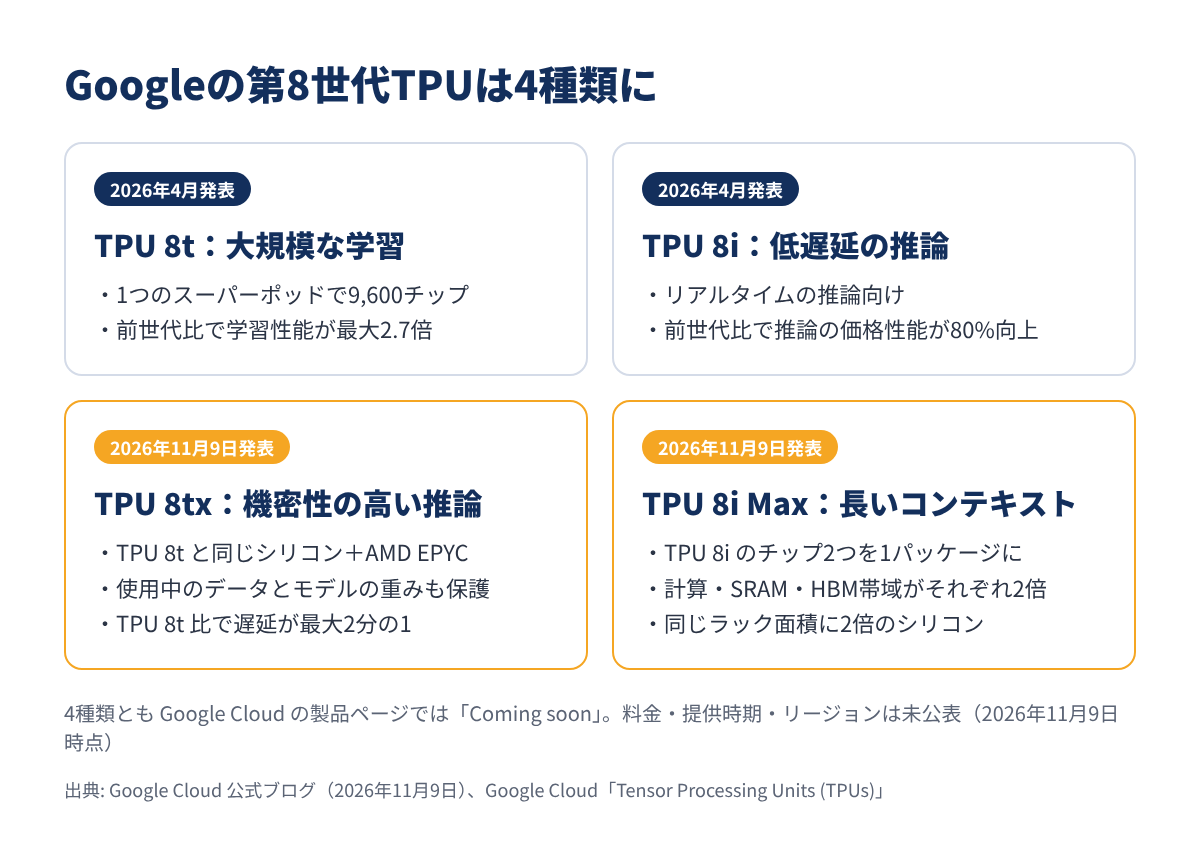
2026年11月9日(米国時間)、Google は AI 用の自社チップ TPU(Tensor Processing Unit)の第8世代に、新しく「TPU 8tx」と「TPU 8i Max」の2つを加えると発表しました。
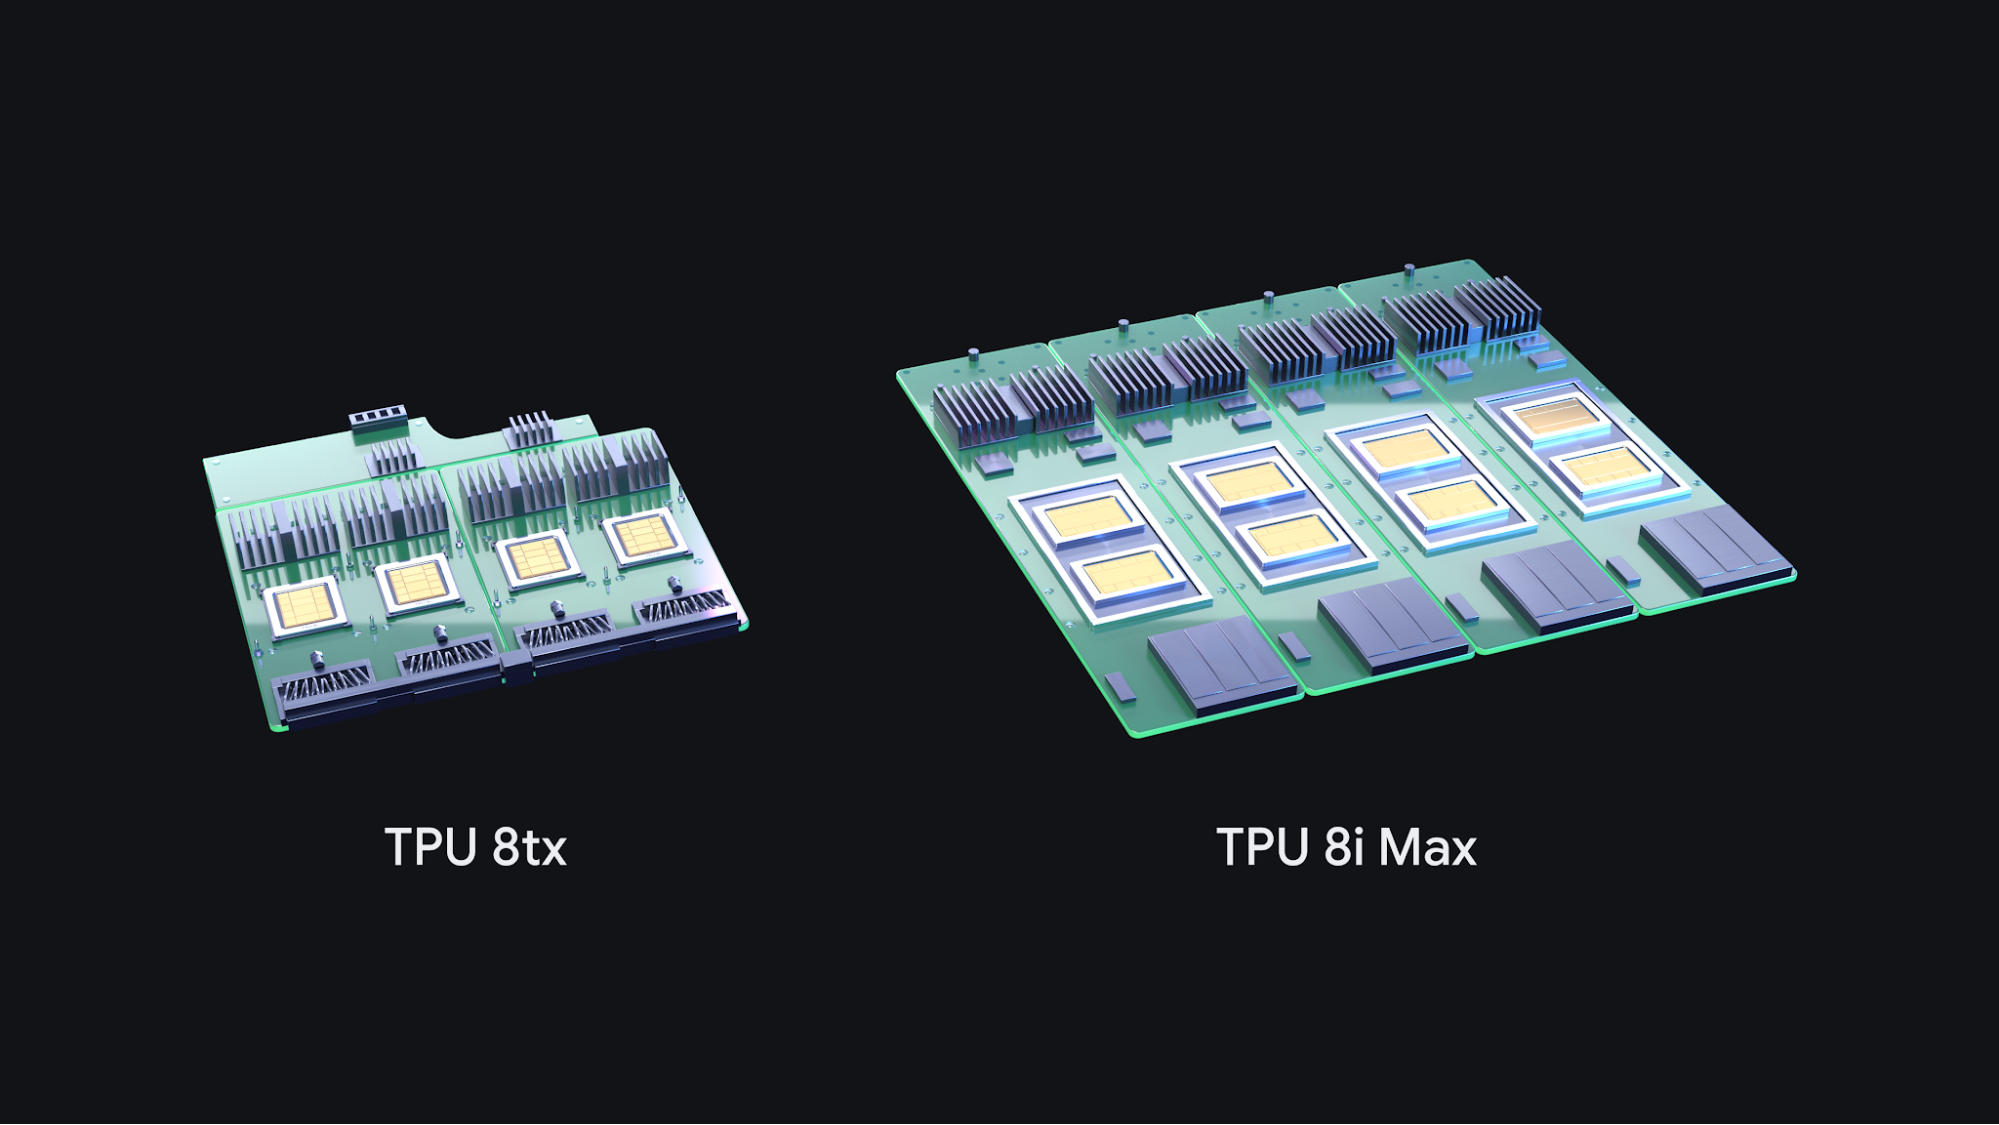
TPU 8tx は「処理中のデータも守る」機密性の高い推論向け、TPU 8i Max は TPU 8i のチップを2つ載せた、長いコンテキスト(一度に扱う文脈)向けです。4月に発表済みの 8t・8i と合わせて、第8世代の TPU は4種類になりました。
ただし、4種類とも Google Cloud の製品ページでは「Coming soon(近日提供)」で、料金もまだ載っていません。一方で、同じ日に Cloud Pathways の一般提供(GA)など、今の TPU ですぐ使えるソフトウェアも発表されています。この記事では、Google の公式発表にある事実だけをもとに、何が変わるのか・誰に関係するのかを整理します。AI の計算基盤を、用途ごとに専用の機械で用意する方向へ一段進めた——という位置づけの発表です。
この記事はこんな人向けです
一言でいうと、AI エージェントを企業で本番運用するときの「2つの悩み」に合わせて作った、第8世代 TPU の派生システムです。Google はその悩みを、ハードウェアの段階でのデータの保護と、100万トークン規模の長いコンテキストだと説明しています。
| 項目 | TPU 8tx | TPU 8i Max |
|---|---|---|
| 位置づけ | 機密性の高い推論(小規模な学習にも向く) | 長いコンテキストとラックあたり最高の計算密度 |
| 主な利用者 | 規制のある業界の企業や政府 | 多数のエージェントで大量の情報を扱う用途 |
| 中身 | TPU 8t と同じシリコン+第5世代 AMD EPYC の CPU ホスト | TPU 8i のチップ2つを1つのパッケージに |
| 公式の数字 | TPU 8t と比べて遅延が最大2分の1 | TPU 8i と比べて計算・SRAM・HBM 帯域がそれぞれ2倍 |
| 提供状況 | Coming soon(時期は未公表) | Coming soon(時期は未公表) |
| 料金 | 未掲載 | 未掲載 |
Google は今回の2つを、新しいチップではなく、新しい「システム」だと強調しています。チップそのものは同じで、周りの CPU・メモリ・ネットワーク・セキュリティの組み合わせを変えて、数年ではなく数か月で専用の機械を出せるようにしている、という説明です。
TPU は、Google が10年以上前から自社で設計している AI 専用のチップです。最初は音声認識や翻訳など Google 社内のために作られましたが、今は Gemini の学習・提供、Google Cloud の顧客向け、さらに顧客のデータセンターへの直接導入にも使われています。Google によると、TPU の顧客は100近くに増えています。
第8世代は、2026年4月の Google Cloud Next で 8t(学習用)と 8i(推論用)の2つから始まりました。Google は、前の世代と比べて 8t は学習性能が最大2.7倍、8i は推論の価格性能が80%向上するとしています。今回の2つを加えて、1年に4つの TPU システムを出すのは初めてです。
| システム | 役割(Google の説明) | 発表 |
|---|---|---|
| TPU 8t | 大規模な学習(1つのスーパーポッドで9,600チップ) | 2026年4月 |
| TPU 8i | 低遅延の推論(リアルタイムの推論) | 2026年4月 |
| TPU 8tx | 機密コンピューティング(安全な推論) | 2026年11月9日 |
| TPU 8i Max | 大きなコンテキストと計算密度 | 2026年11月9日 |
Google は、この4つで 「エージェントの一生のどの段階にも専用のアクセラレーターがある」状態になったと説明しています。
TPU 8tx は、規制のある企業や政府が、最も機密性の高いデータと一緒に AI モデルやエージェントを動かすためのシステムです。
ふつう、データは保存するときや送るときは暗号化されていても、コンピューターが処理する間はメモリの上で暗号を解く必要があります。TPU 8tx はセキュリティをハードウェアの層に組み込み、使用中のデータとモデルの重み(学習で得たパラメータ)も保護・分離するとしています。
構成は、TPU 8t と同じシリコンに、第5世代 AMD EPYC の CPU ホストを組み合わせたものです。
TPU 8tx は、リアルタイムの推論向けに作った低遅延の「Boardfly」ネットワークを使います。Google によると、TPU 8t と比べて遅延が最大2分の1で、性能の低下はほぼゼロです。何段階も処理を重ねるエージェントを止めずに動かせる、という説明です。
学習向けの計算力と、推論向けの速いネットワークを組み合わせたことで、1つのシステムでモデルを動かしながら、自社データで調整することができます。具体的には次の3つです。
いずれも、機密データを別のクラスターへ移さずに行えるとしています。
TPU 8i Max が狙うのは、Google が 「メモリの壁」と呼ぶ問題です。何十ものエージェントがソフトウェアのコード全体や何時間もの動画を一度に扱うと、計算より先にメモリの帯域(データを運ぶ速さ)が足りなくなります。
そこで Google は、低遅延の TPU 8i のチップ2つを、1つのパッケージにまとめました。
| 比べる点 | TPU 8i Max(TPU 8i 比) |
|---|---|
| 計算能力 | 2倍 |
| SRAM(チップ内の高速メモリ) | 2倍 |
| HBM 帯域(チップ横の広帯域メモリの速さ) | 2倍 |
| ラックの設置面積 | 今と同じ面積に2倍のシリコン |
計算とメモリを同じ割合で増やすことで、大きな処理でもデータ待ちで止まりにくくしています。さらに、今のラックと同じ面積に2倍のチップを収めるため、データセンターの面積あたり・電力あたりの計算能力を大きく増やせるとしています。
なお、TPU 8i Max のメモリ容量やチップ数などの具体的な仕様は、今回の発表には書かれていません。
新しい TPU はまだ「Coming soon」ですが、同じ日に TPU を使いやすくするソフトウェアもまとめて発表されました。こちらは今の世代の TPU でも使えるものが中心です。
Cloud Pathways は、Google DeepMind が Gemini などのために作った分散処理の仕組みです。1つのプログラム(コントローラー)から、何千もの TPU チップを1台のように扱えます。Google によると、直近90日で1億3,000万 TPU チップ時間以上がこの仕組みで処理されています。
GKE dynamic slicing は、TPU の確保と、ジョブが使う TPU のまとまり(スライス)の組み立てを切り離す機能です。光回線のスイッチで、確保済みの TPU をつないで大きくしたり、小さく分けたりします。Google によると、ジョブの起動が最大5倍、障害からの復旧が最大4.5倍速くなります。ドキュメントでは、TPU の「All Capacity」モードでだけ使えるとされています。
TPU Sync は、TPU のメモリ・サーバーのメモリ・共有ストレージ・ネットワークを、1つのメモリの階層として扱うライブラリです。長い会話で膨らむ KV キャッシュ(AI がそれまでの文脈を覚えておくデータ)を、自動でチップの外へ逃がします。
Google の検証では、2,350億〜4,800億パラメータの MoE モデルで、TPU Sync を使わない場合と比べて KV の転送の遅れを90%以上、最初のトークンが出るまでの時間(TTFT)を平均90%短くできたとしています。
ほかにも、次のような発表がありました。
TPU 8tx と TPU 8i Max の提供時期・料金は、まだ公表されていません。2026年11月9日時点の公式ページで分かることは、次のとおりです。
| 項目 | 2026年11月9日時点 |
|---|---|
| TPU 8tx・TPU 8i Max | 製品ページで 「Coming soon」(時期は未公表) |
| TPU 8t・TPU 8i(4月発表) | 同じく 「Coming soon」 |
| いま一般提供されている TPU | Ironwood(第7世代)、Trillium(第6世代) など |
| 料金 | 料金ページは Ironwood・Trillium・v5p・v5e のみ。第8世代は未掲載 |
| 提供するリージョン(日本を含むか) | 未公表 |
| Cloud Pathways(GKE)・GKE dynamic slicing | 一般提供(GA) |
| TPU Sync | オープンソースで公開 |
| TPU agent suite | プレビュー |
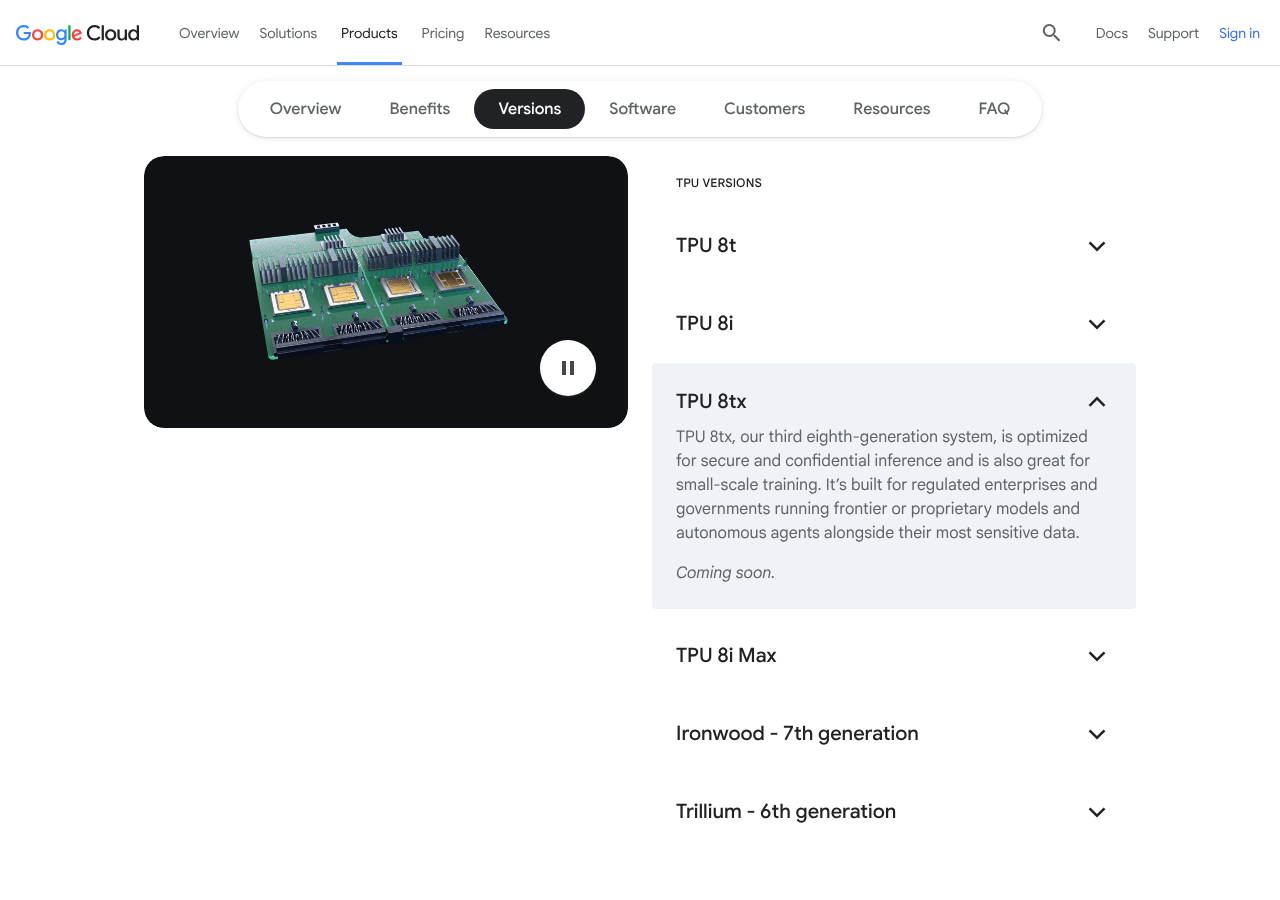
新しい TPU を前提に予算を組むのは、まだ早い段階です。一般提供のときに、料金とリージョンが示されるのを待つ必要があります。
TPU に限らず、クラウドで AI を動かすときは想定外の請求への備えも大切です。Google Cloud で利用額に上限を設ける仕組みは、こちらの記事で解説しています。
今回の発表ですぐ影響があるのは、すでに Google Cloud で TPU を使っている人です。Cloud Pathways と GKE dynamic slicing は一般提供になったので、大きな学習・推論の運用を見直すきっかけになります。
| 立場 | 関係するところ |
|---|---|
| GKE で TPU を使っている | Cloud Pathways(GA)と dynamic slicing(GA)で、ジョブの起動・障害からの復旧を速くできる |
| PyTorch で開発している | TorchTPU・TPU agent suite(プレビュー)で、TPU を試すハードルが下がる |
| 金融・医療・行政など機密データを扱う | TPU 8tx が提供されれば、処理中のデータも守った形で AI を動かす選択肢になる |
| 長い文書・コード・動画をエージェントで扱う | TPU 8i Max・TPU Sync が、長いコンテキストの処理に関係する |
| Gemini などを API で使うだけ | 直接の変化はない(基盤の話) |
Gemini などを API で使うだけの人にとっては、裏側の基盤の話です。ただし、Google は TPU の上で自社の Gemini を学習・提供しているので、長期的には AI サービスの速さや価格にもつながる発表といえます。
英語圏の技術コミュニティ Hacker News では、Google の発表へのリンクが投稿されましたが、2026年11月9日時点ではポイント・コメントとも少なめです(Hacker News)。出ている声を紹介します。
「すごそうだが、いつ使えるのか」という声は、提供時期が未公表の今回の発表をよく表しています。
今回の発表は、AI の計算基盤を「何でもこなす1つの機械」から「用途ごとの専用の機械」へ分けていく流れを、はっきり示したものだと考えています。学習・推論・機密・長いコンテキストと、エージェントの用途ごとにハードウェアを用意するという考え方です。
特に TPU 8tx は、日本の企業にも意味が大きいと見ています。金融・医療・行政など、データの扱いが理由でクラウドの AI を見送ってきた組織にとって、「処理中も守られる」ことをハードウェアで示せるのは、社内の説明材料になりえます。ただし、日本のリージョンで使えるのか、どの認証・規制に対応するのかは、まだ分かりません。
一方で、今回の4種類はどれも「Coming soon」です。Google Cloud の利用者が今すぐ取り組めるのは、Cloud Pathways や dynamic slicing、TorchTPU といったソフトウェア側です。新しい TPU は、料金とリージョンが出てから判断するのがよいでしょう。
Google Cloud は、自社の Gemini だけでなく OpenAI のモデルも扱う方向に進んでいます。モデルの選択肢と、それを動かすチップの両方を広げているのが、今の Google Cloud の姿だと受け止めています。
Google の新しい TPU「8tx」「8i Max」のポイントをまとめます。
すでに TPU を使っている人は Cloud Pathways と dynamic slicing を、これから検討する人は TorchTPU から試し、新しい TPU は料金とリージョンの発表を待つのがおすすめです。